


Procedura per addestrare una piccola rete neurale PyTorch su Azure Machine Learning, confrontare due addestramenti, registrare il modello e pubblicarlo su un endpoint in tempo reale, poi chiamarlo da una console .NET. Le risorse si creano, si provano e si eliminano dal portale e dallo studio di Azure Machine Learning; dal computer si scrive il programma di addestramento, che è un file Python, e la console .NET.
Occorre: un account Azure con una sottoscrizione attiva e .NET 10 sul computer. Durata: più di un'ora, quasi tutta di attesa: circa un quarto d'ora per ogni addestramento e venti minuti per la pubblicazione. Costo: meno di un dollaro, se elimini le risorse alla fine. Il portale indica 0,27 dollari l'ora per la macchina dell'addestramento e 0,12 dollari l'ora per quella dell'endpoint.
Il portale e lo studio delle schermate sono in inglese: i nomi dei comandi sono riportati come appaiono a schermo.
L'area di lavoro
1. Crea l'area di lavoro
Apri https://portal.azure.com/#create/Microsoft.MachineLearningServices e compila:
- Resource group: Create new,
rg-guide-ml-01, OK - Name:
mlw-guide-extranet-01 - Region: West Europe
Il portale propone da solo l'account di archiviazione, il Key Vault e Application Insights.
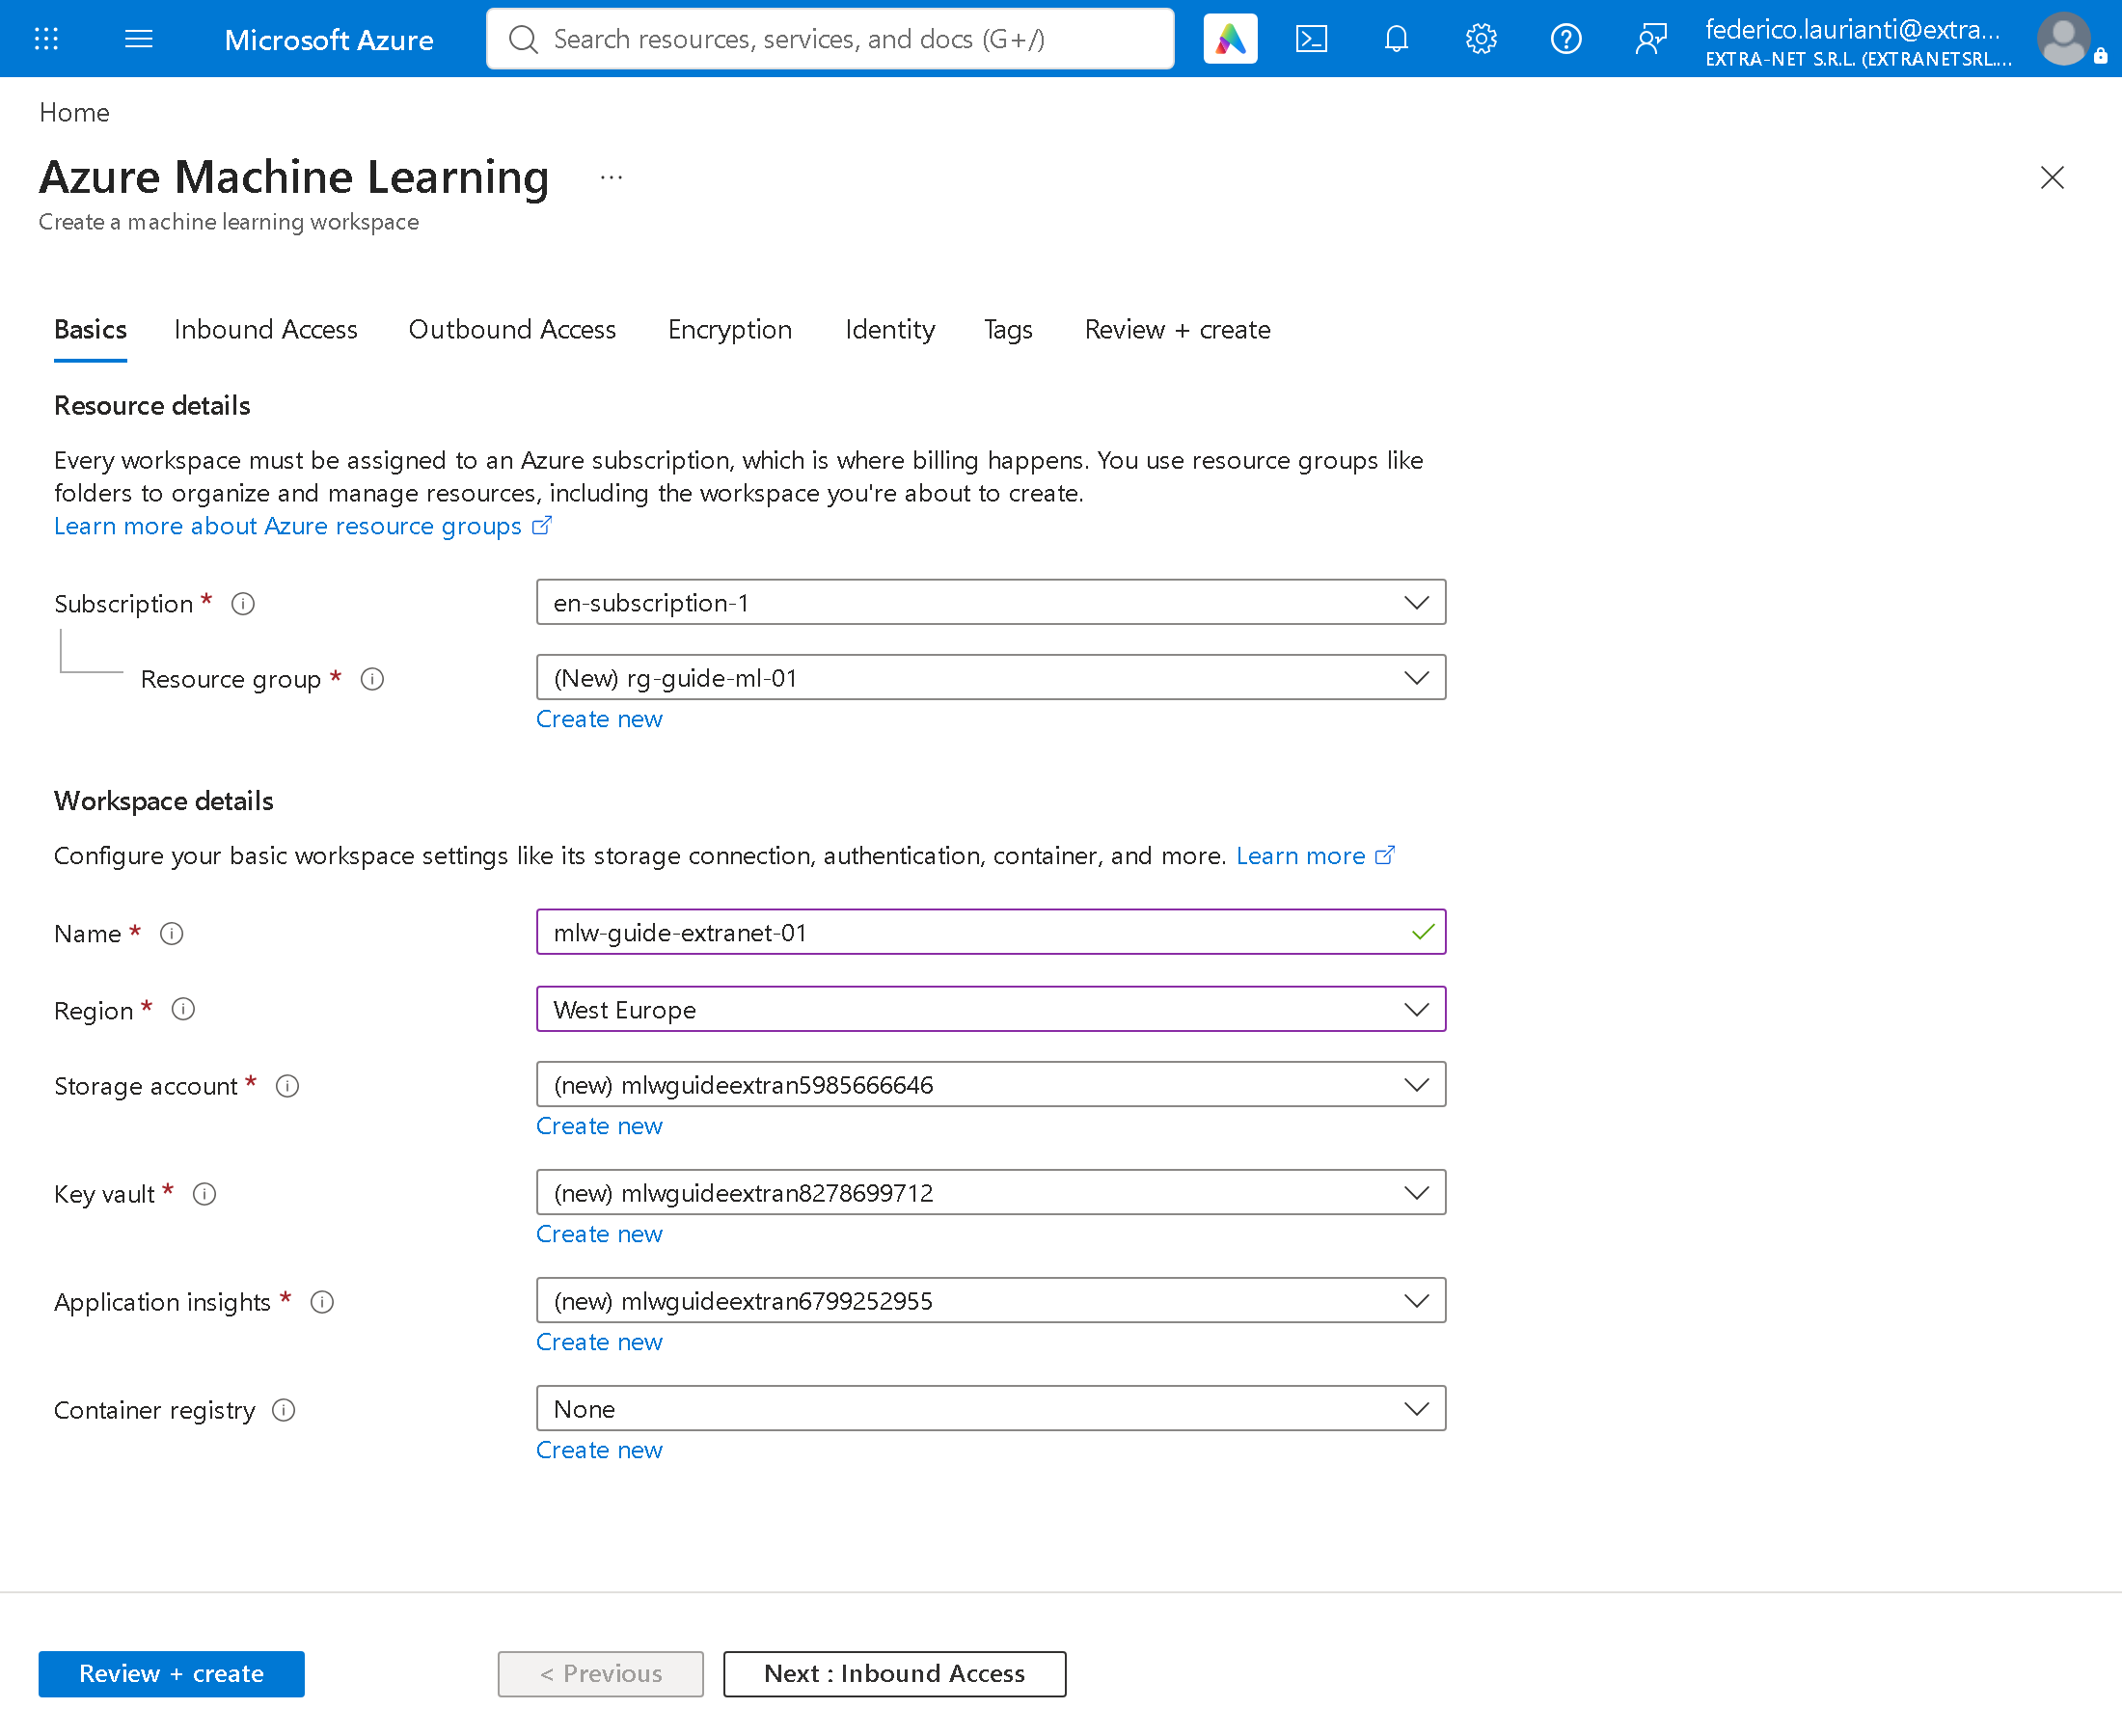
Premi Review + create.
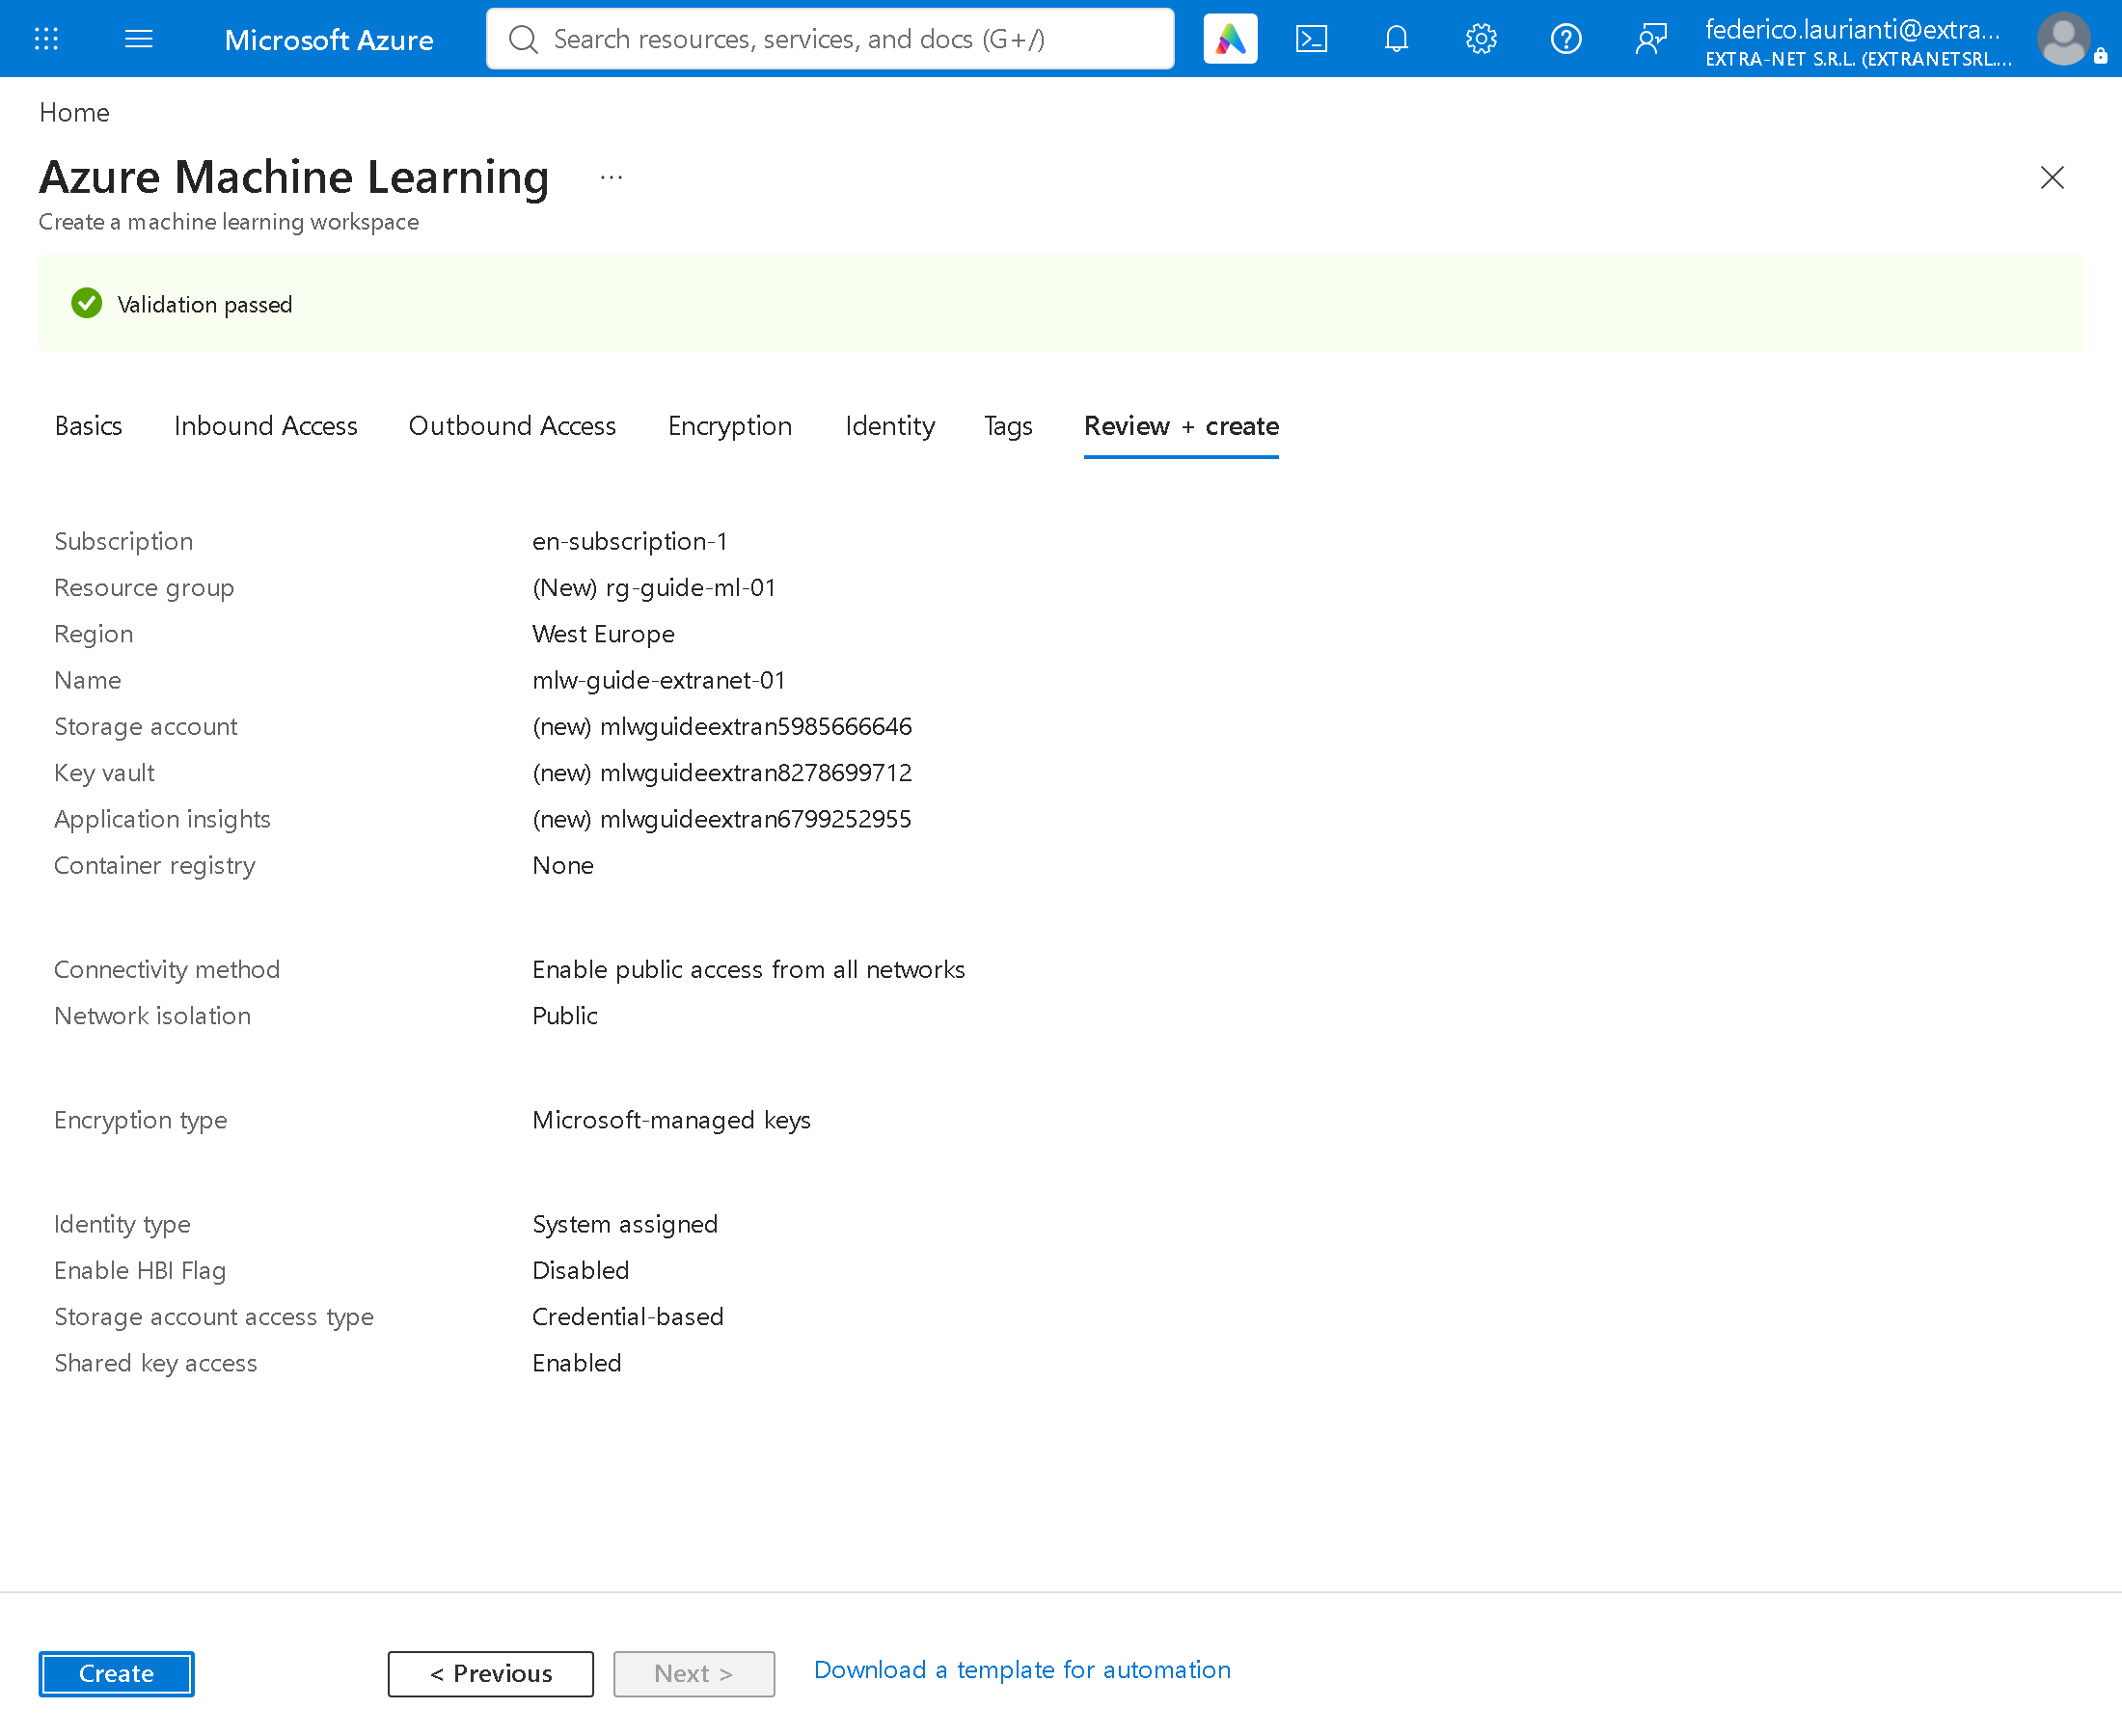
Premi Create e aspetta Your deployment is complete.
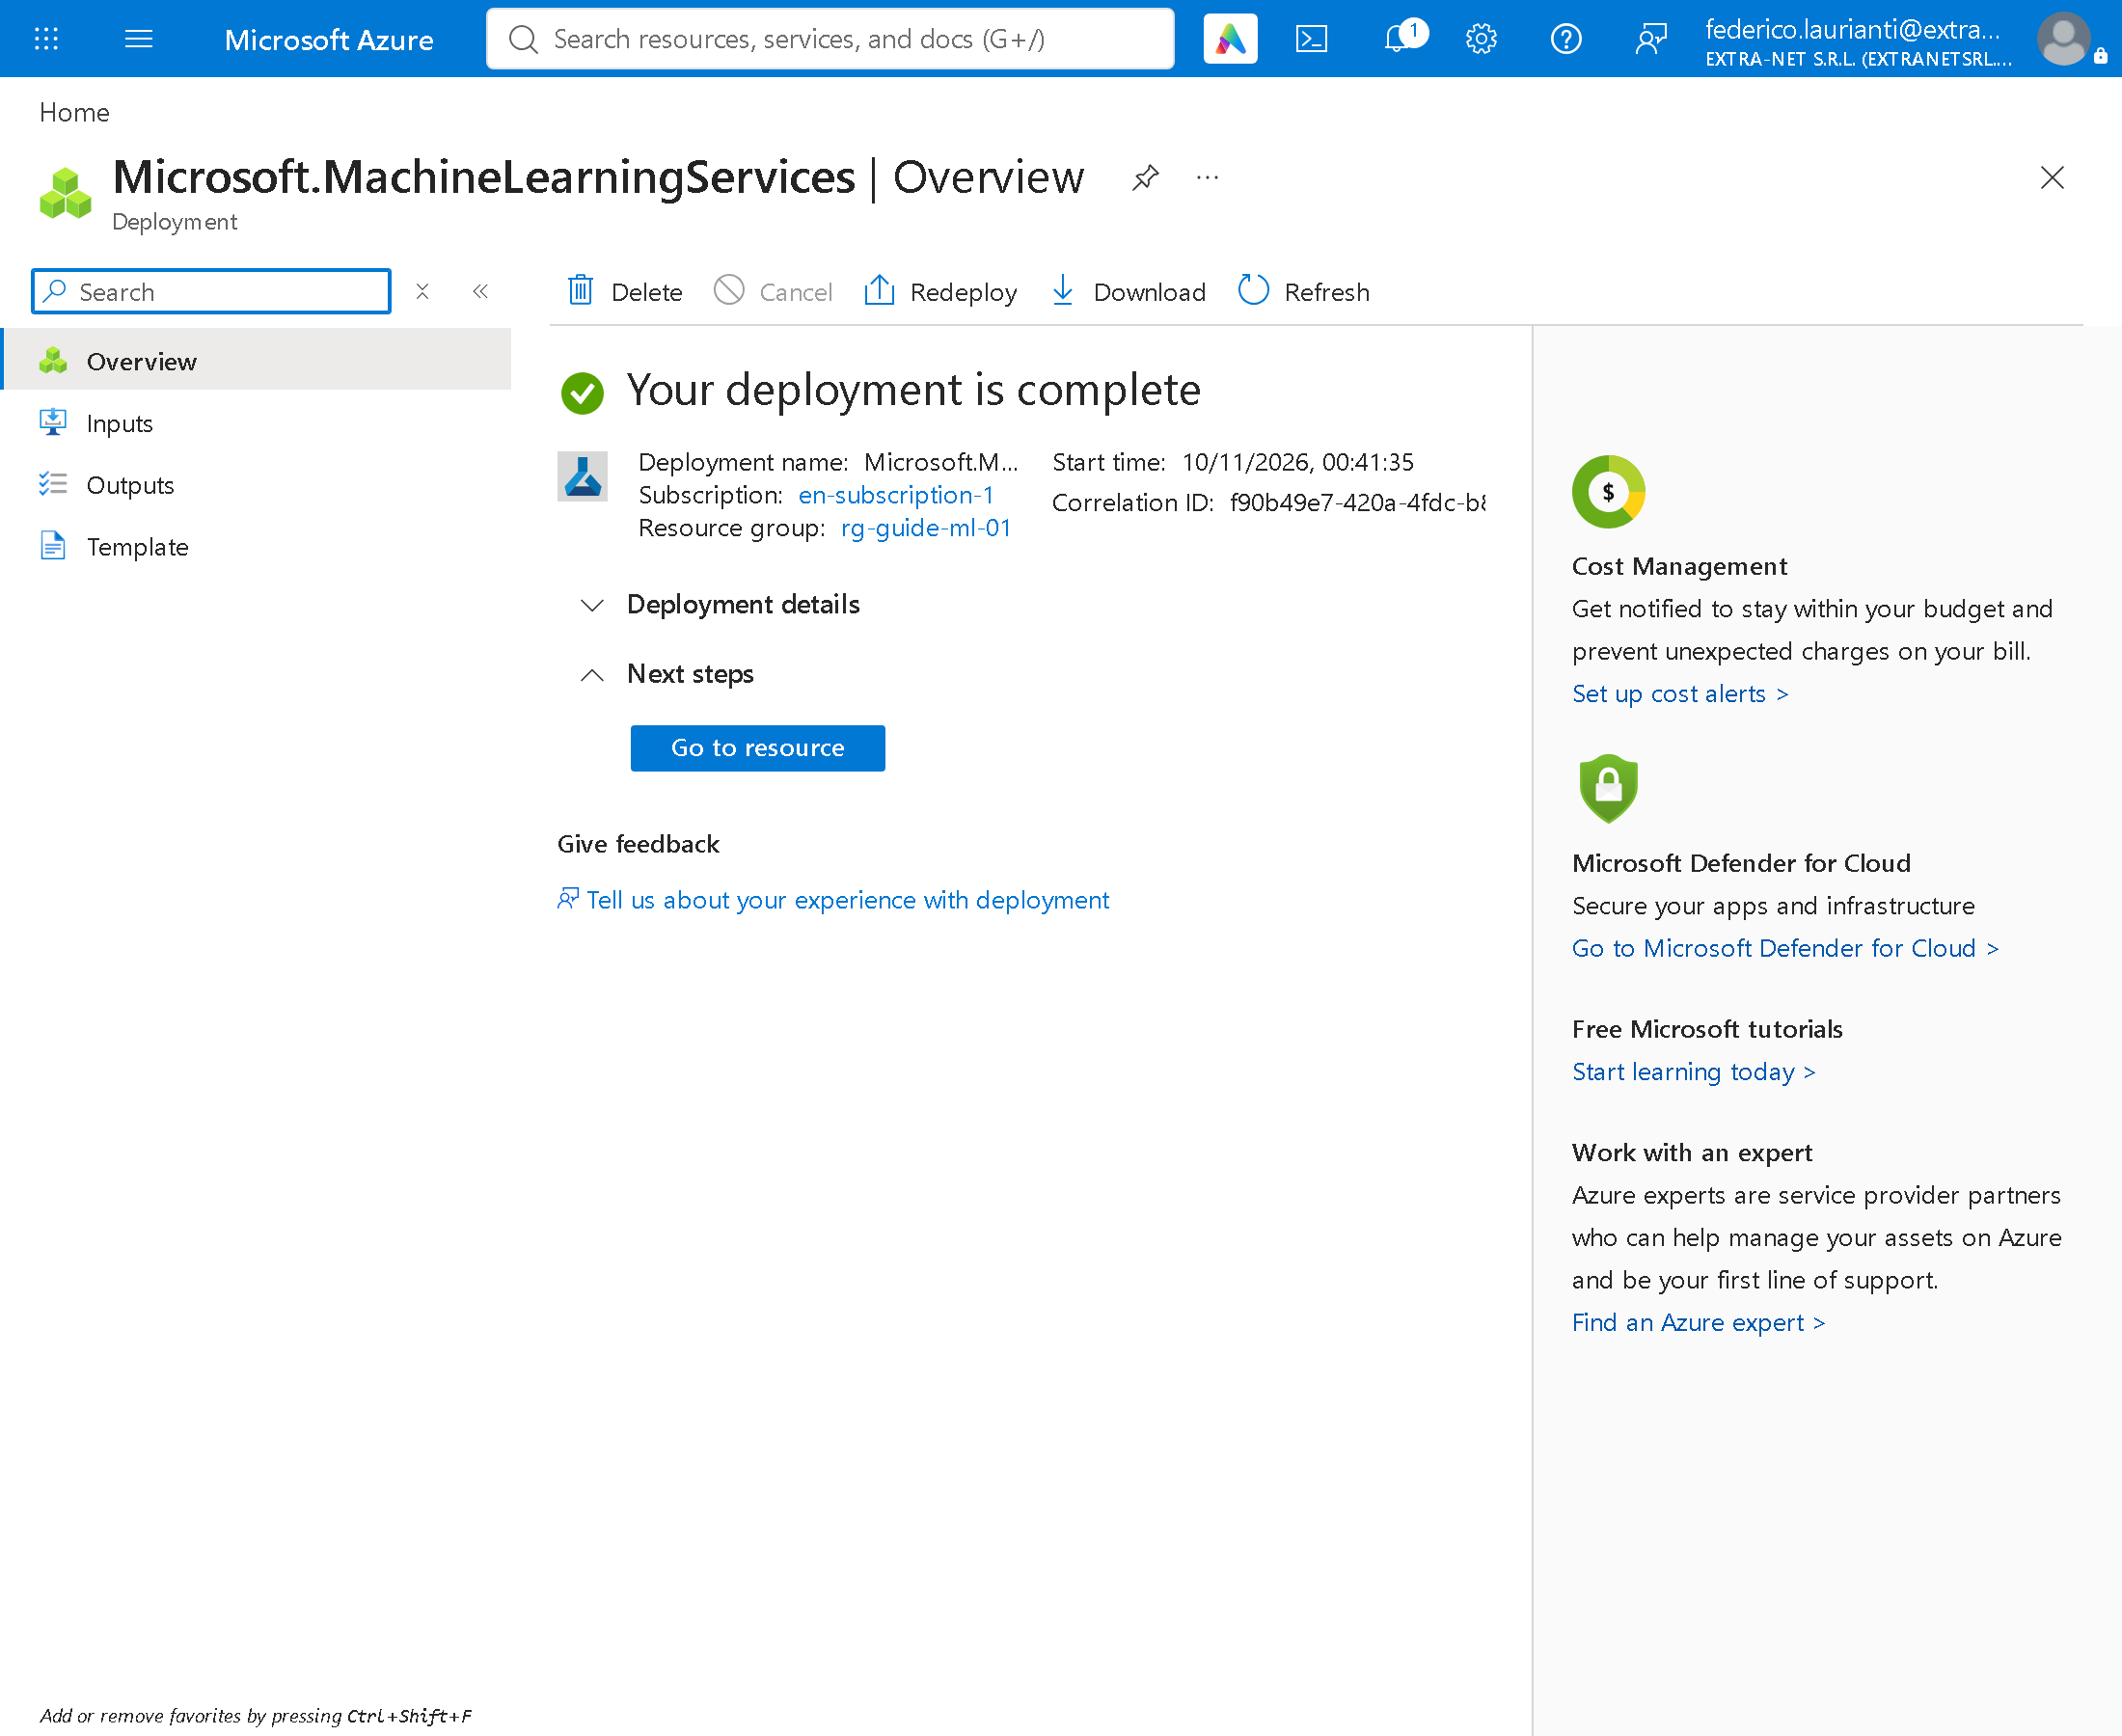
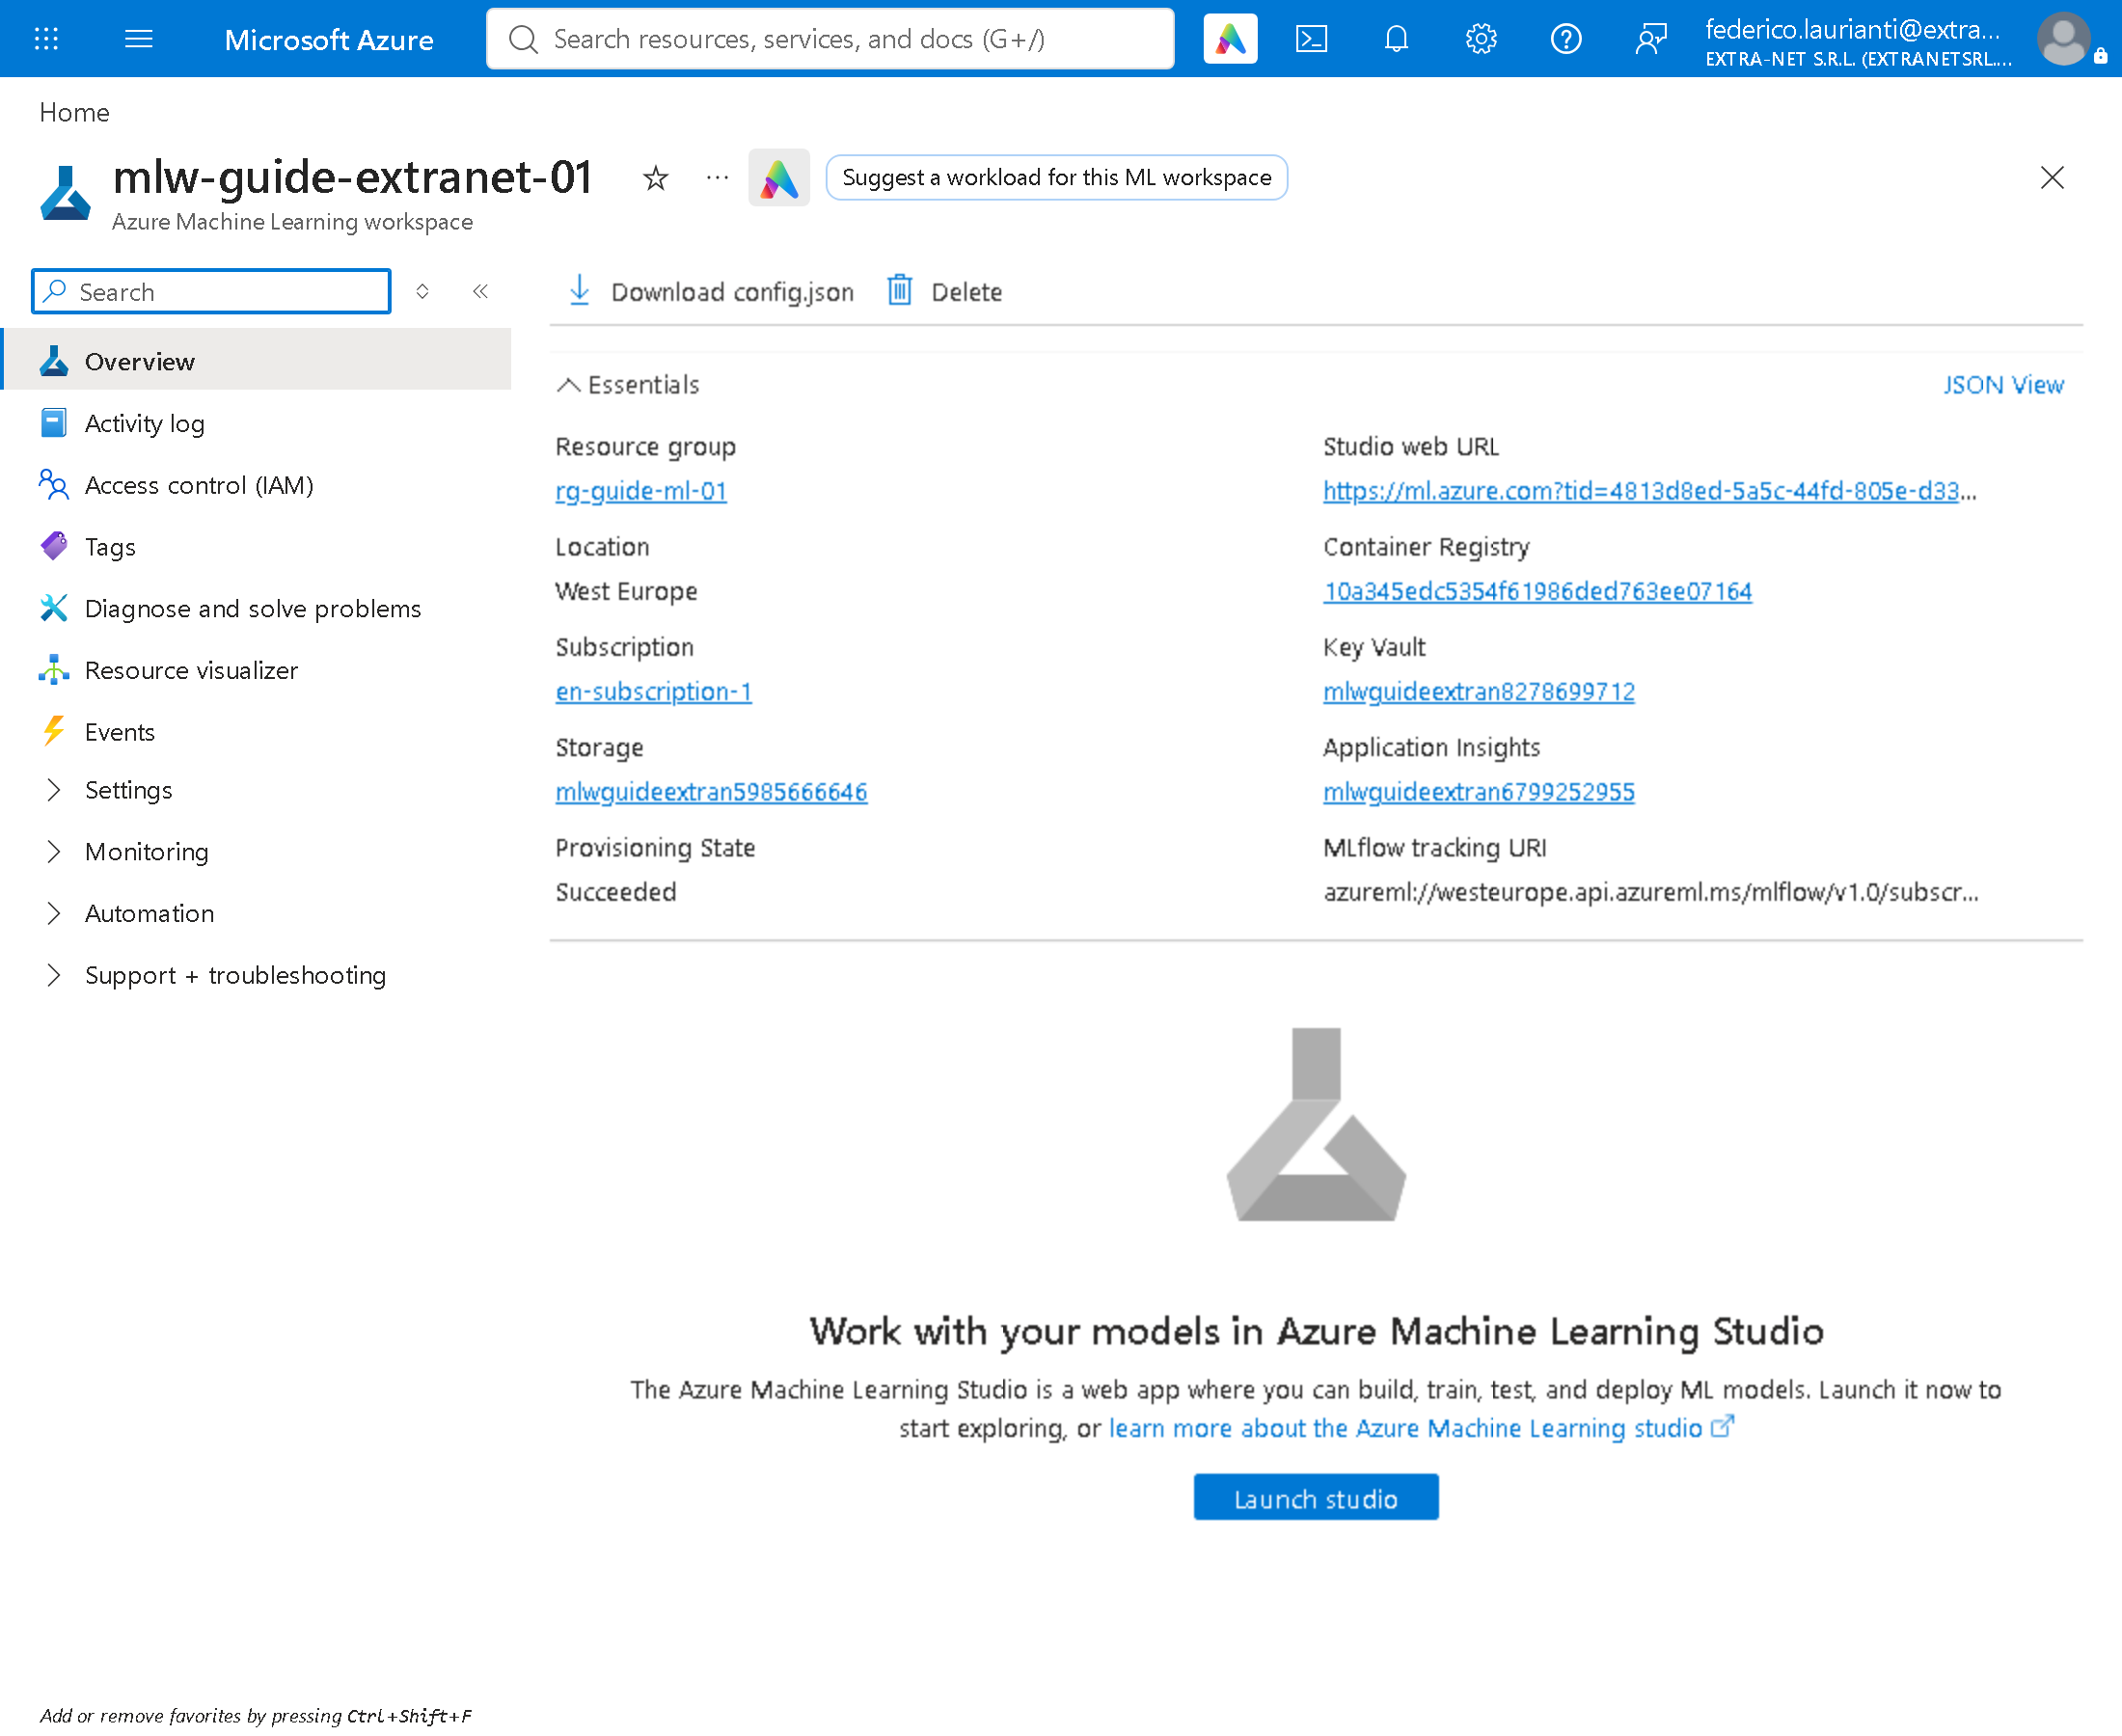
2. Apri lo studio
Premi Go to resource e poi Launch studio. I passi seguenti, fino alla pubblicazione, si fanno nello studio.
L'addestramento
3. Scrivi il programma di addestramento
Sul computer crea il file train.py. Addestra una rete con uno strato nascosto sul dataset Iris di scikit-learn: 150 fiori, quattro misure per fiore, tre specie da riconoscere.
import argparse

import mlflow
import mlflow.pytorch
import pandas as pd
import torch
from mlflow.models import infer_signature
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from torch import nn

parser = argparse.ArgumentParser()
parser.add_argument("--epochs", type=int, default=200)
parser.add_argument("--hidden", type=int, default=8)
parser.add_argument("--lr", type=float, default=0.01)
args = parser.parse_args()

iris = load_iris(as_frame=True)
columns = ["sepal_length", "sepal_width", "petal_length", "petal_width"]
features = iris.data.set_axis(columns, axis=1).astype("float32")
x_train, x_test, y_train, y_test = train_test_split(
    features, iris.target, test_size=0.3, random_state=42, stratify=iris.target)

to_x = lambda frame: torch.tensor(frame.values, dtype=torch.float32)
to_y = lambda series: torch.tensor(series.values, dtype=torch.long)

torch.manual_seed(42)
network = nn.Sequential(nn.Linear(4, args.hidden), nn.ReLU(), nn.Linear(args.hidden, 3))
optimizer = torch.optim.Adam(network.parameters(), lr=args.lr)
loss_function = nn.CrossEntropyLoss()

mlflow.log_params(vars(args))

for epoch in range(args.epochs):
    optimizer.zero_grad()
    loss = loss_function(network(to_x(x_train)), to_y(y_train))
    loss.backward()
    optimizer.step()
    if epoch % 10 == 0:
        mlflow.log_metric("loss", loss.item(), step=epoch)

model = nn.Sequential(network, nn.Softmax(dim=1)).eval()
with torch.no_grad():
    probabilities = model(to_x(x_test))
accuracy = (probabilities.argmax(dim=1) == to_y(y_test)).float().mean().item()
mlflow.log_metric("accuracy", accuracy)
print(f"accuracy: {accuracy:.4f}")

signature = infer_signature(x_test, pd.DataFrame(probabilities.numpy()))
requirements = [
    f"mlflow=={mlflow.__version__}",
    f"torch=={torch.__version__.split('+')[0]}",
    "cloudpickle",
    "pandas<3",
    "azureml-ai-monitoring",
]
mlflow.pytorch.save_model(model, "model", signature=signature,
                          serialization_format="pickle", pip_requirements=requirements)
mlflow.log_artifacts("model", artifact_path="model")
I parametri e le metriche registrati con MLflow compaiono nello studio. Le ultime righe salvano il modello nel formato che Azure sa pubblicare senza script di inferenza. In questa prova ognuna di queste scelte ha evitato un errore:
save_modelseguito dalog_artifacts, perchémlflow.pytorch.log_modelcon MLflow 3.15 si è fermato su una chiamata che Azure Machine Learning non accetta.serialization_format="pickle", perché con MLflow 3 il formato predefinito per PyTorch richiede un esempio di dati in ingresso.pandas<3, perché senza questa riga il modello chiede pandas 3.1.1, MLflow 3.15 vuole pandas inferiore a 3 e Azure non riesce a costruire l'immagine dell'endpoint.azureml-ai-monitoring, perché lo script di inferenza generato da Azure importa questo pacchetto e senza di esso l'endpoint non parte.
4. Imposta il primo addestramento
Nello studio apri Jobs, premi Create job, scegli Run a custom training script e premi Start configuring job.
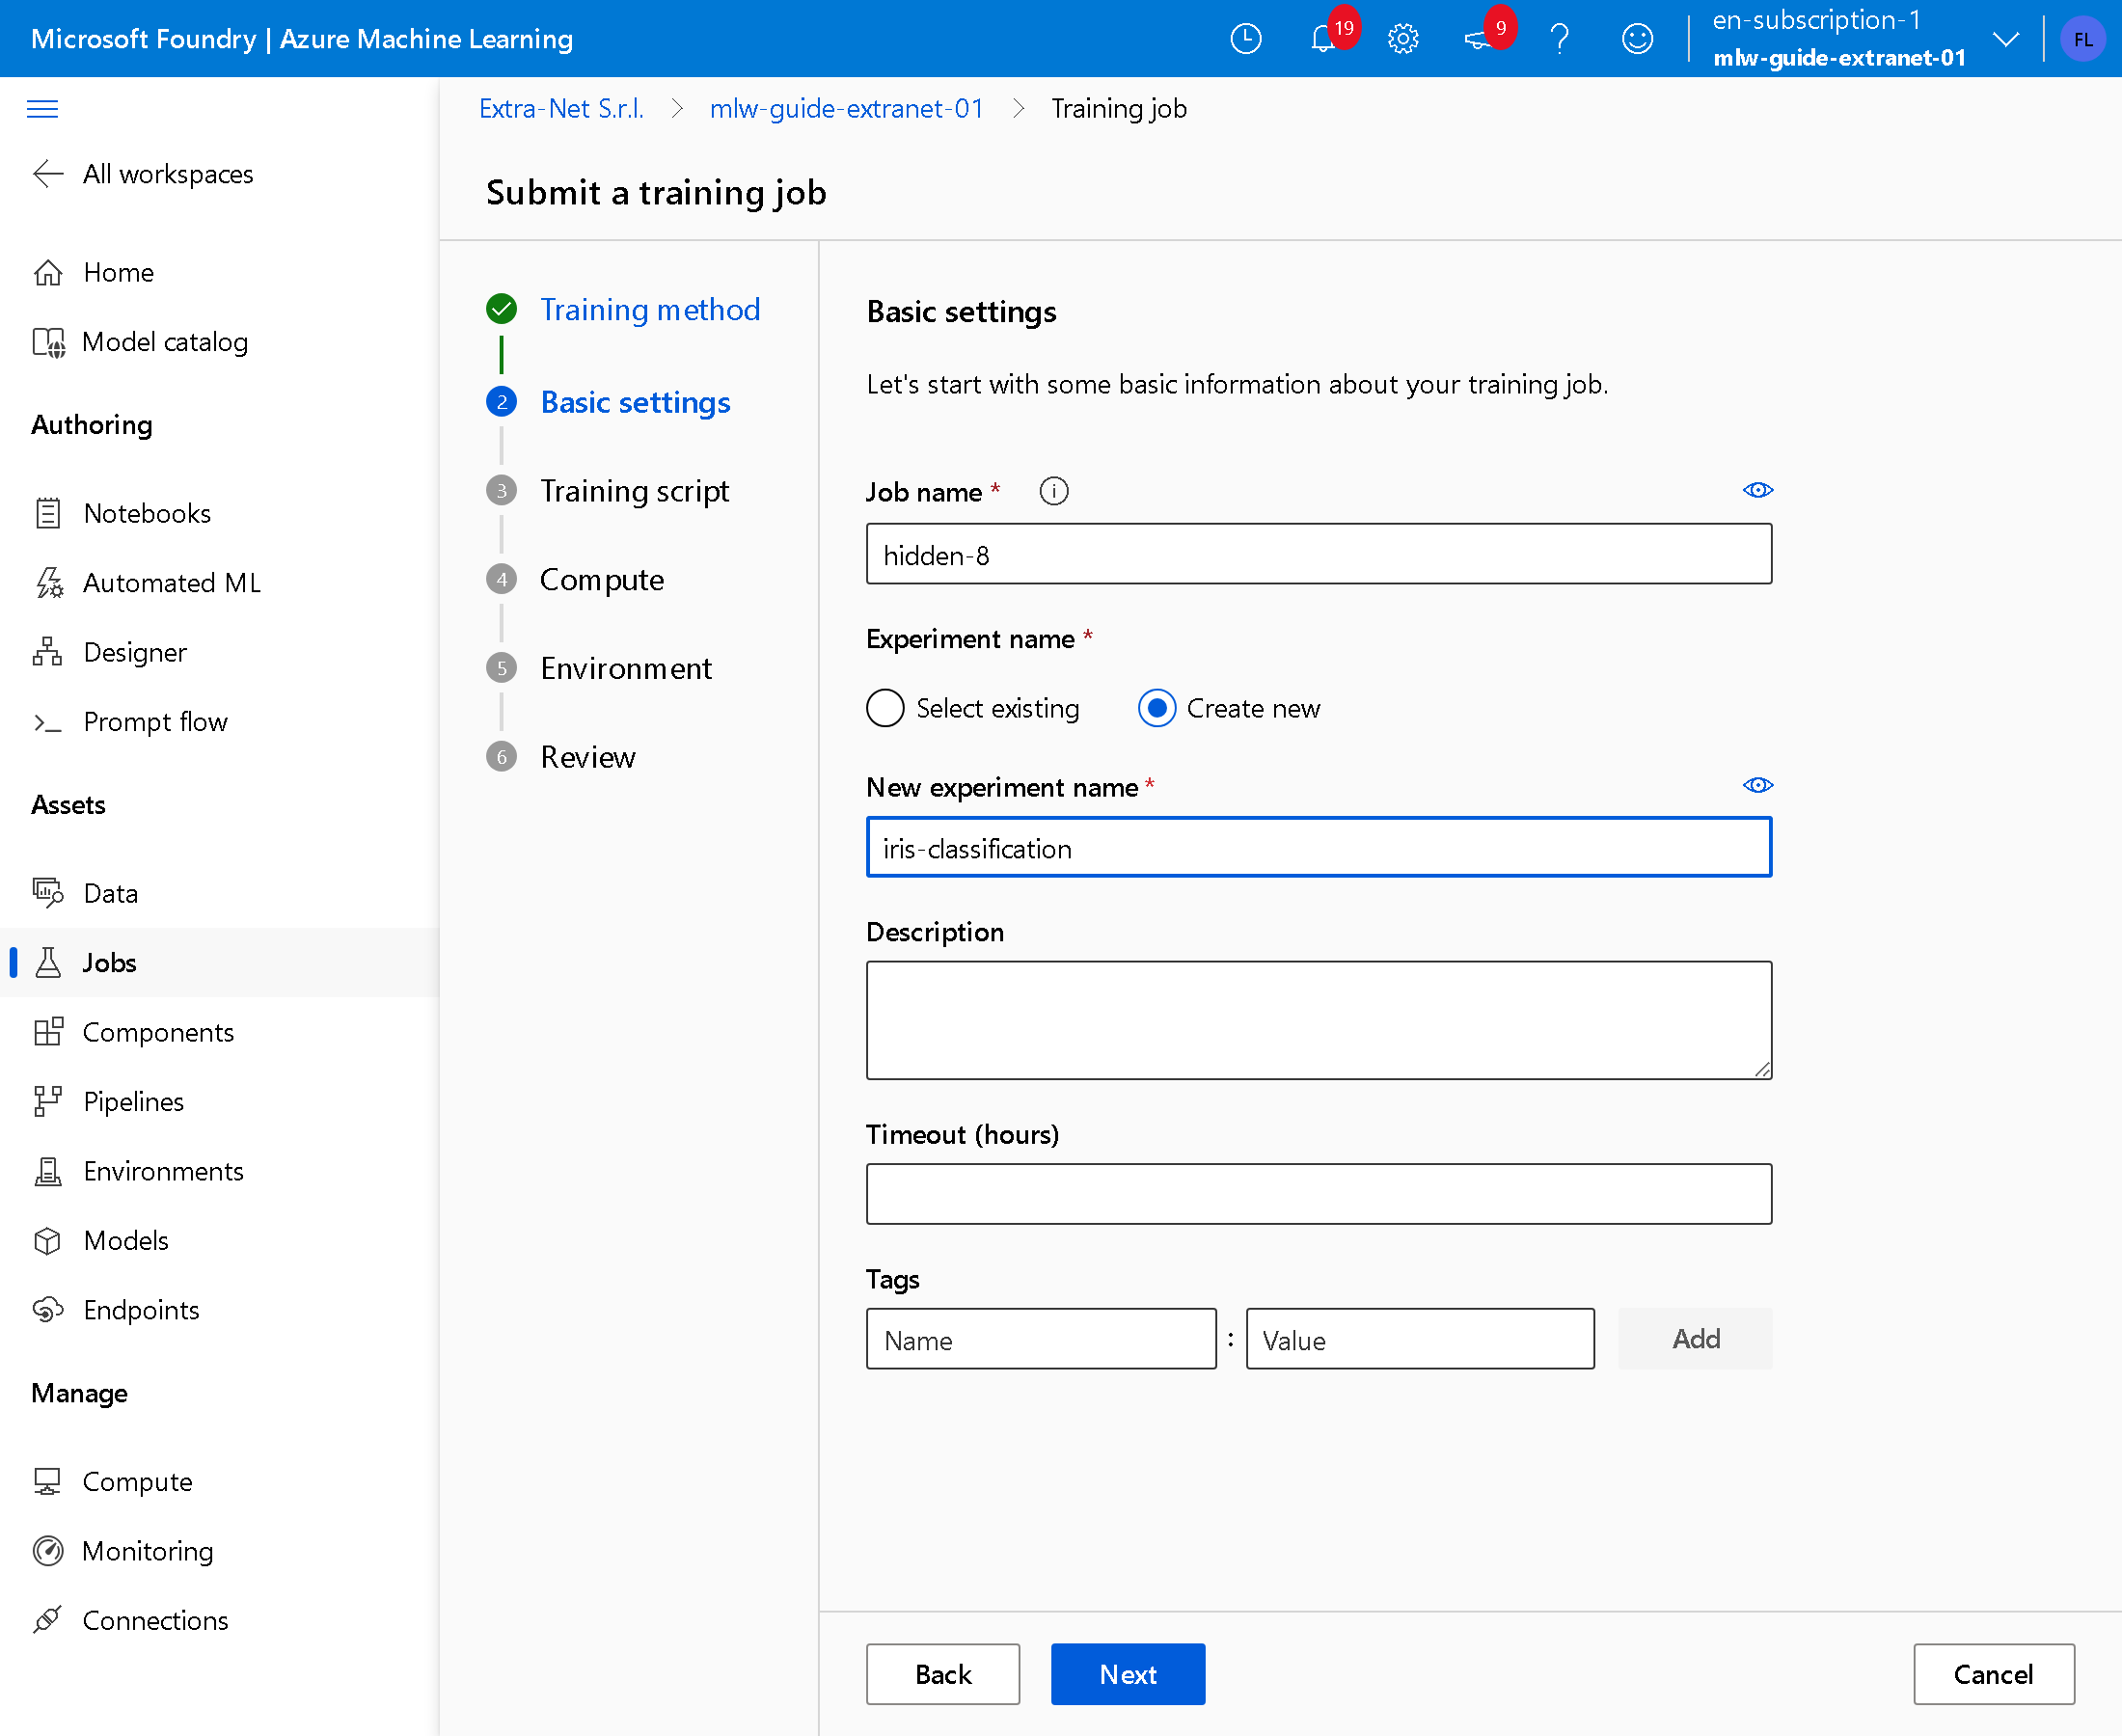
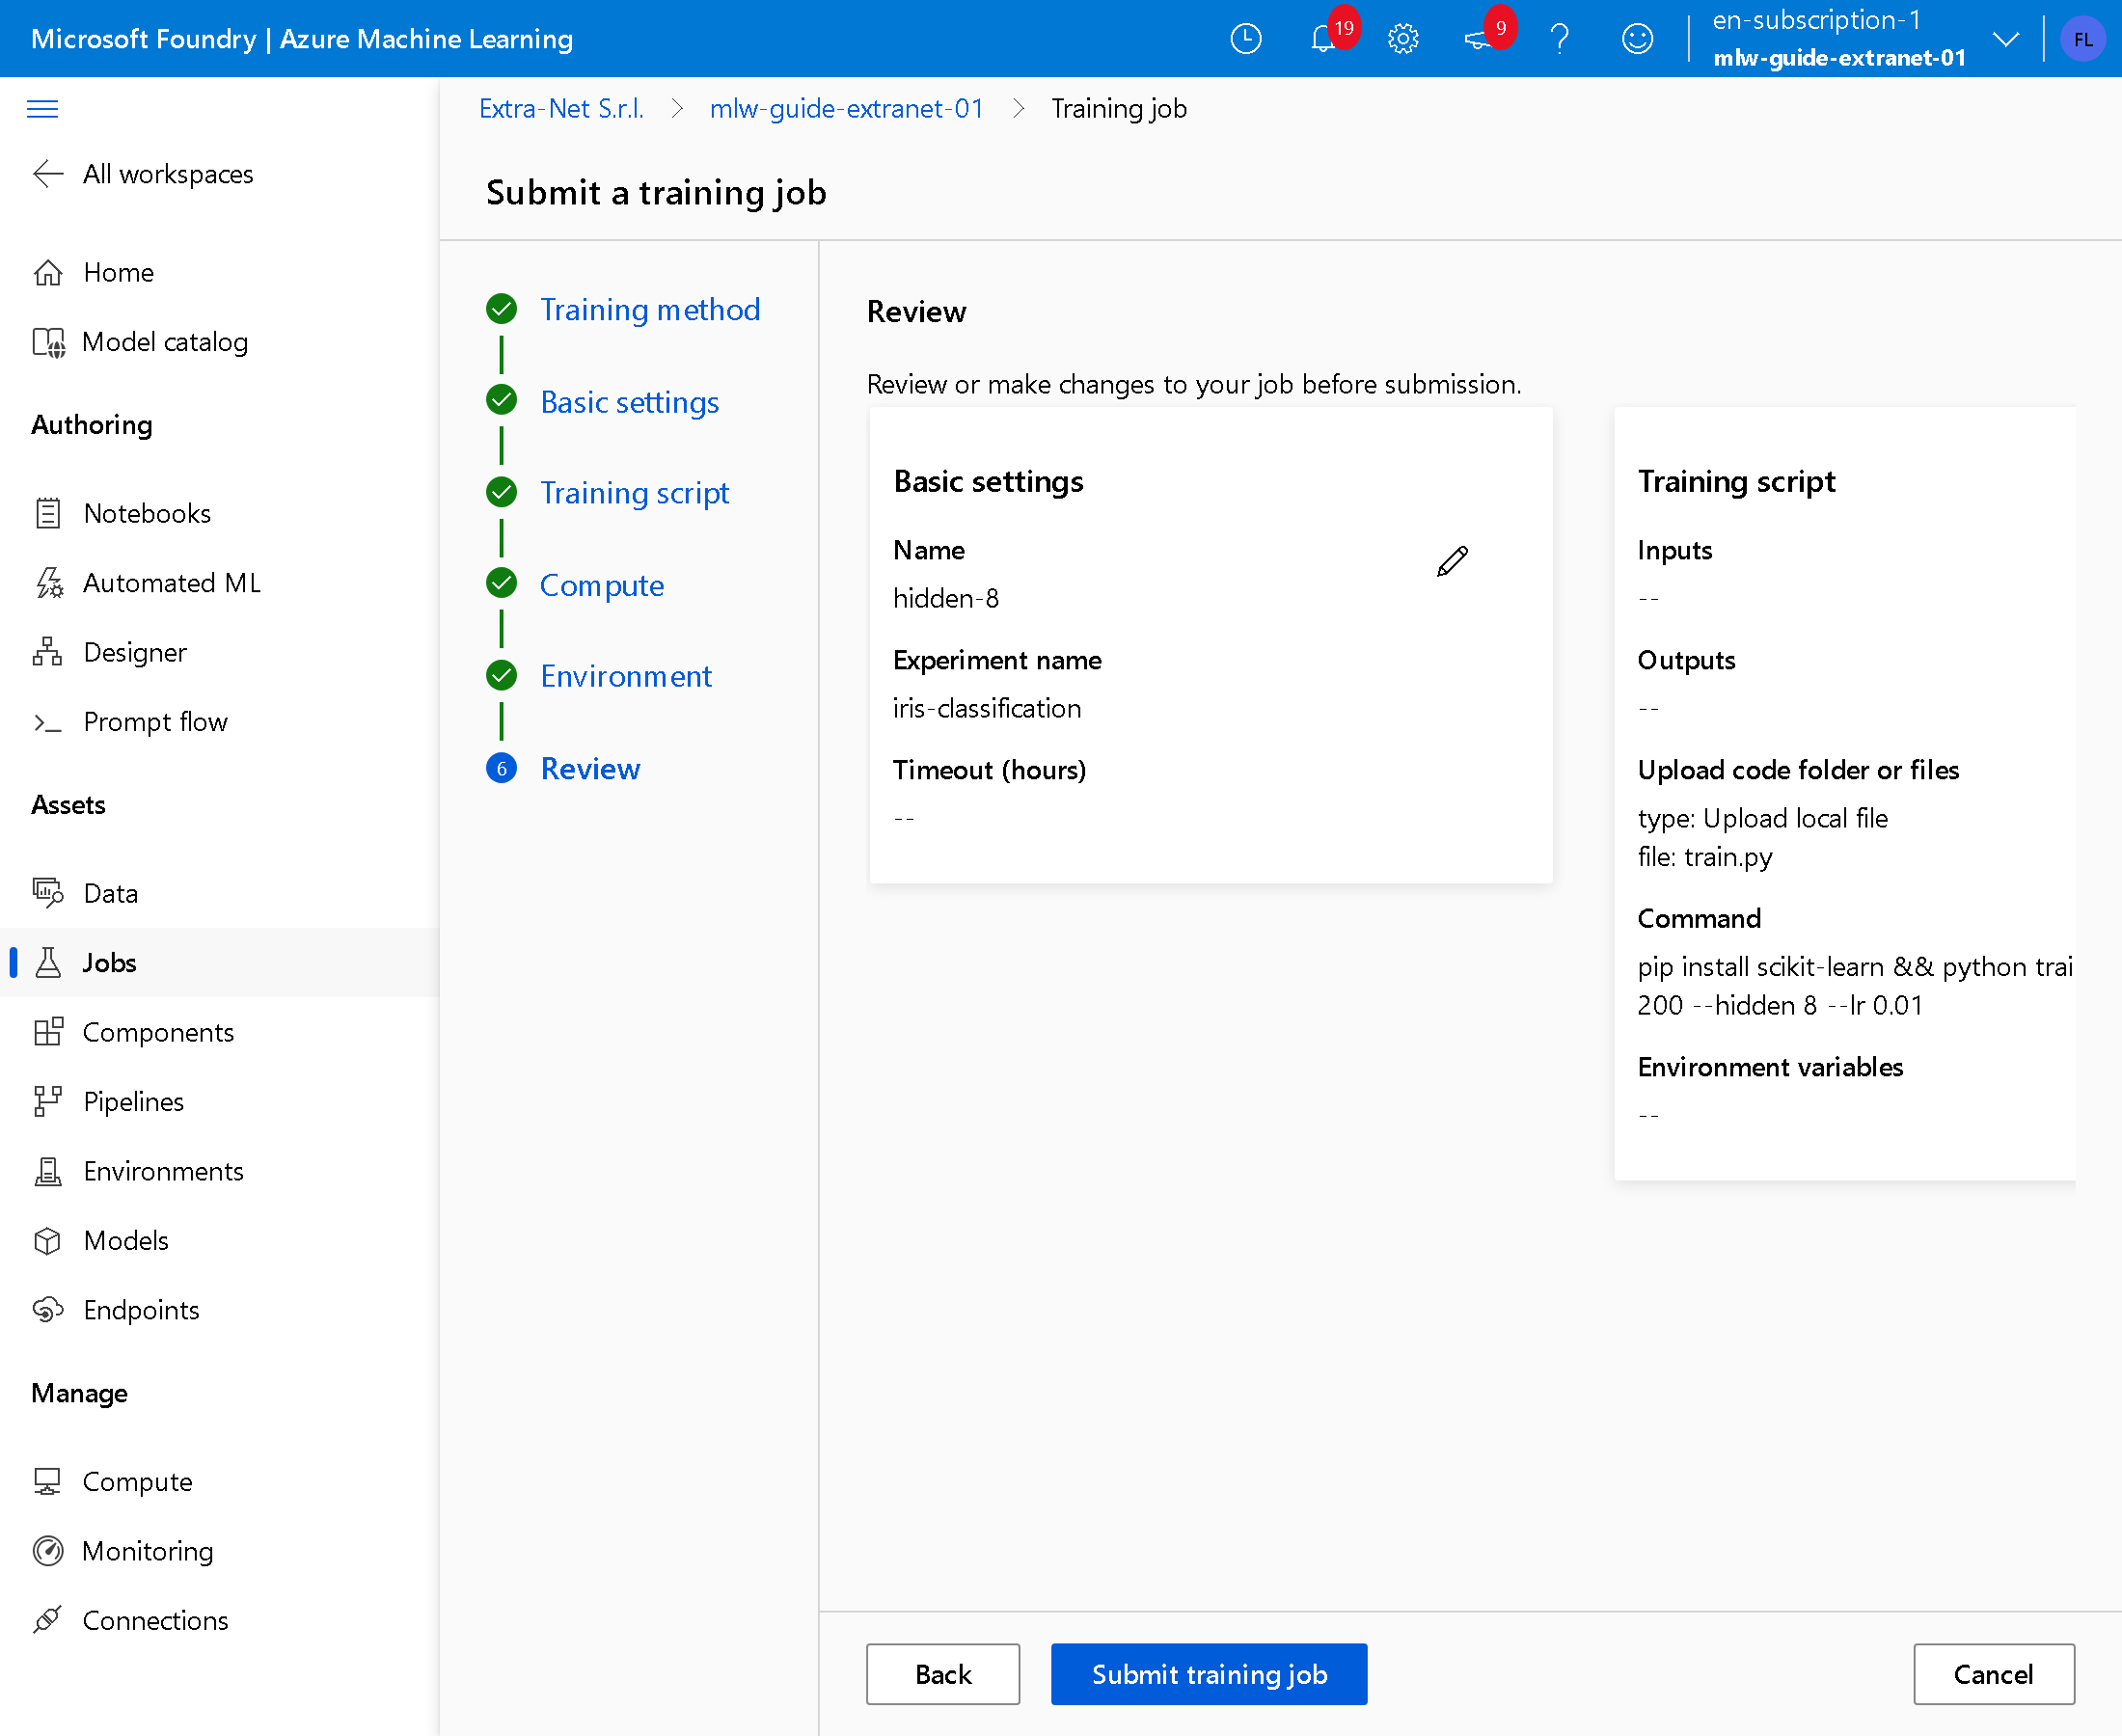
In Job name scrivi hidden-8, in New experiment name iris-classification e premi Next.
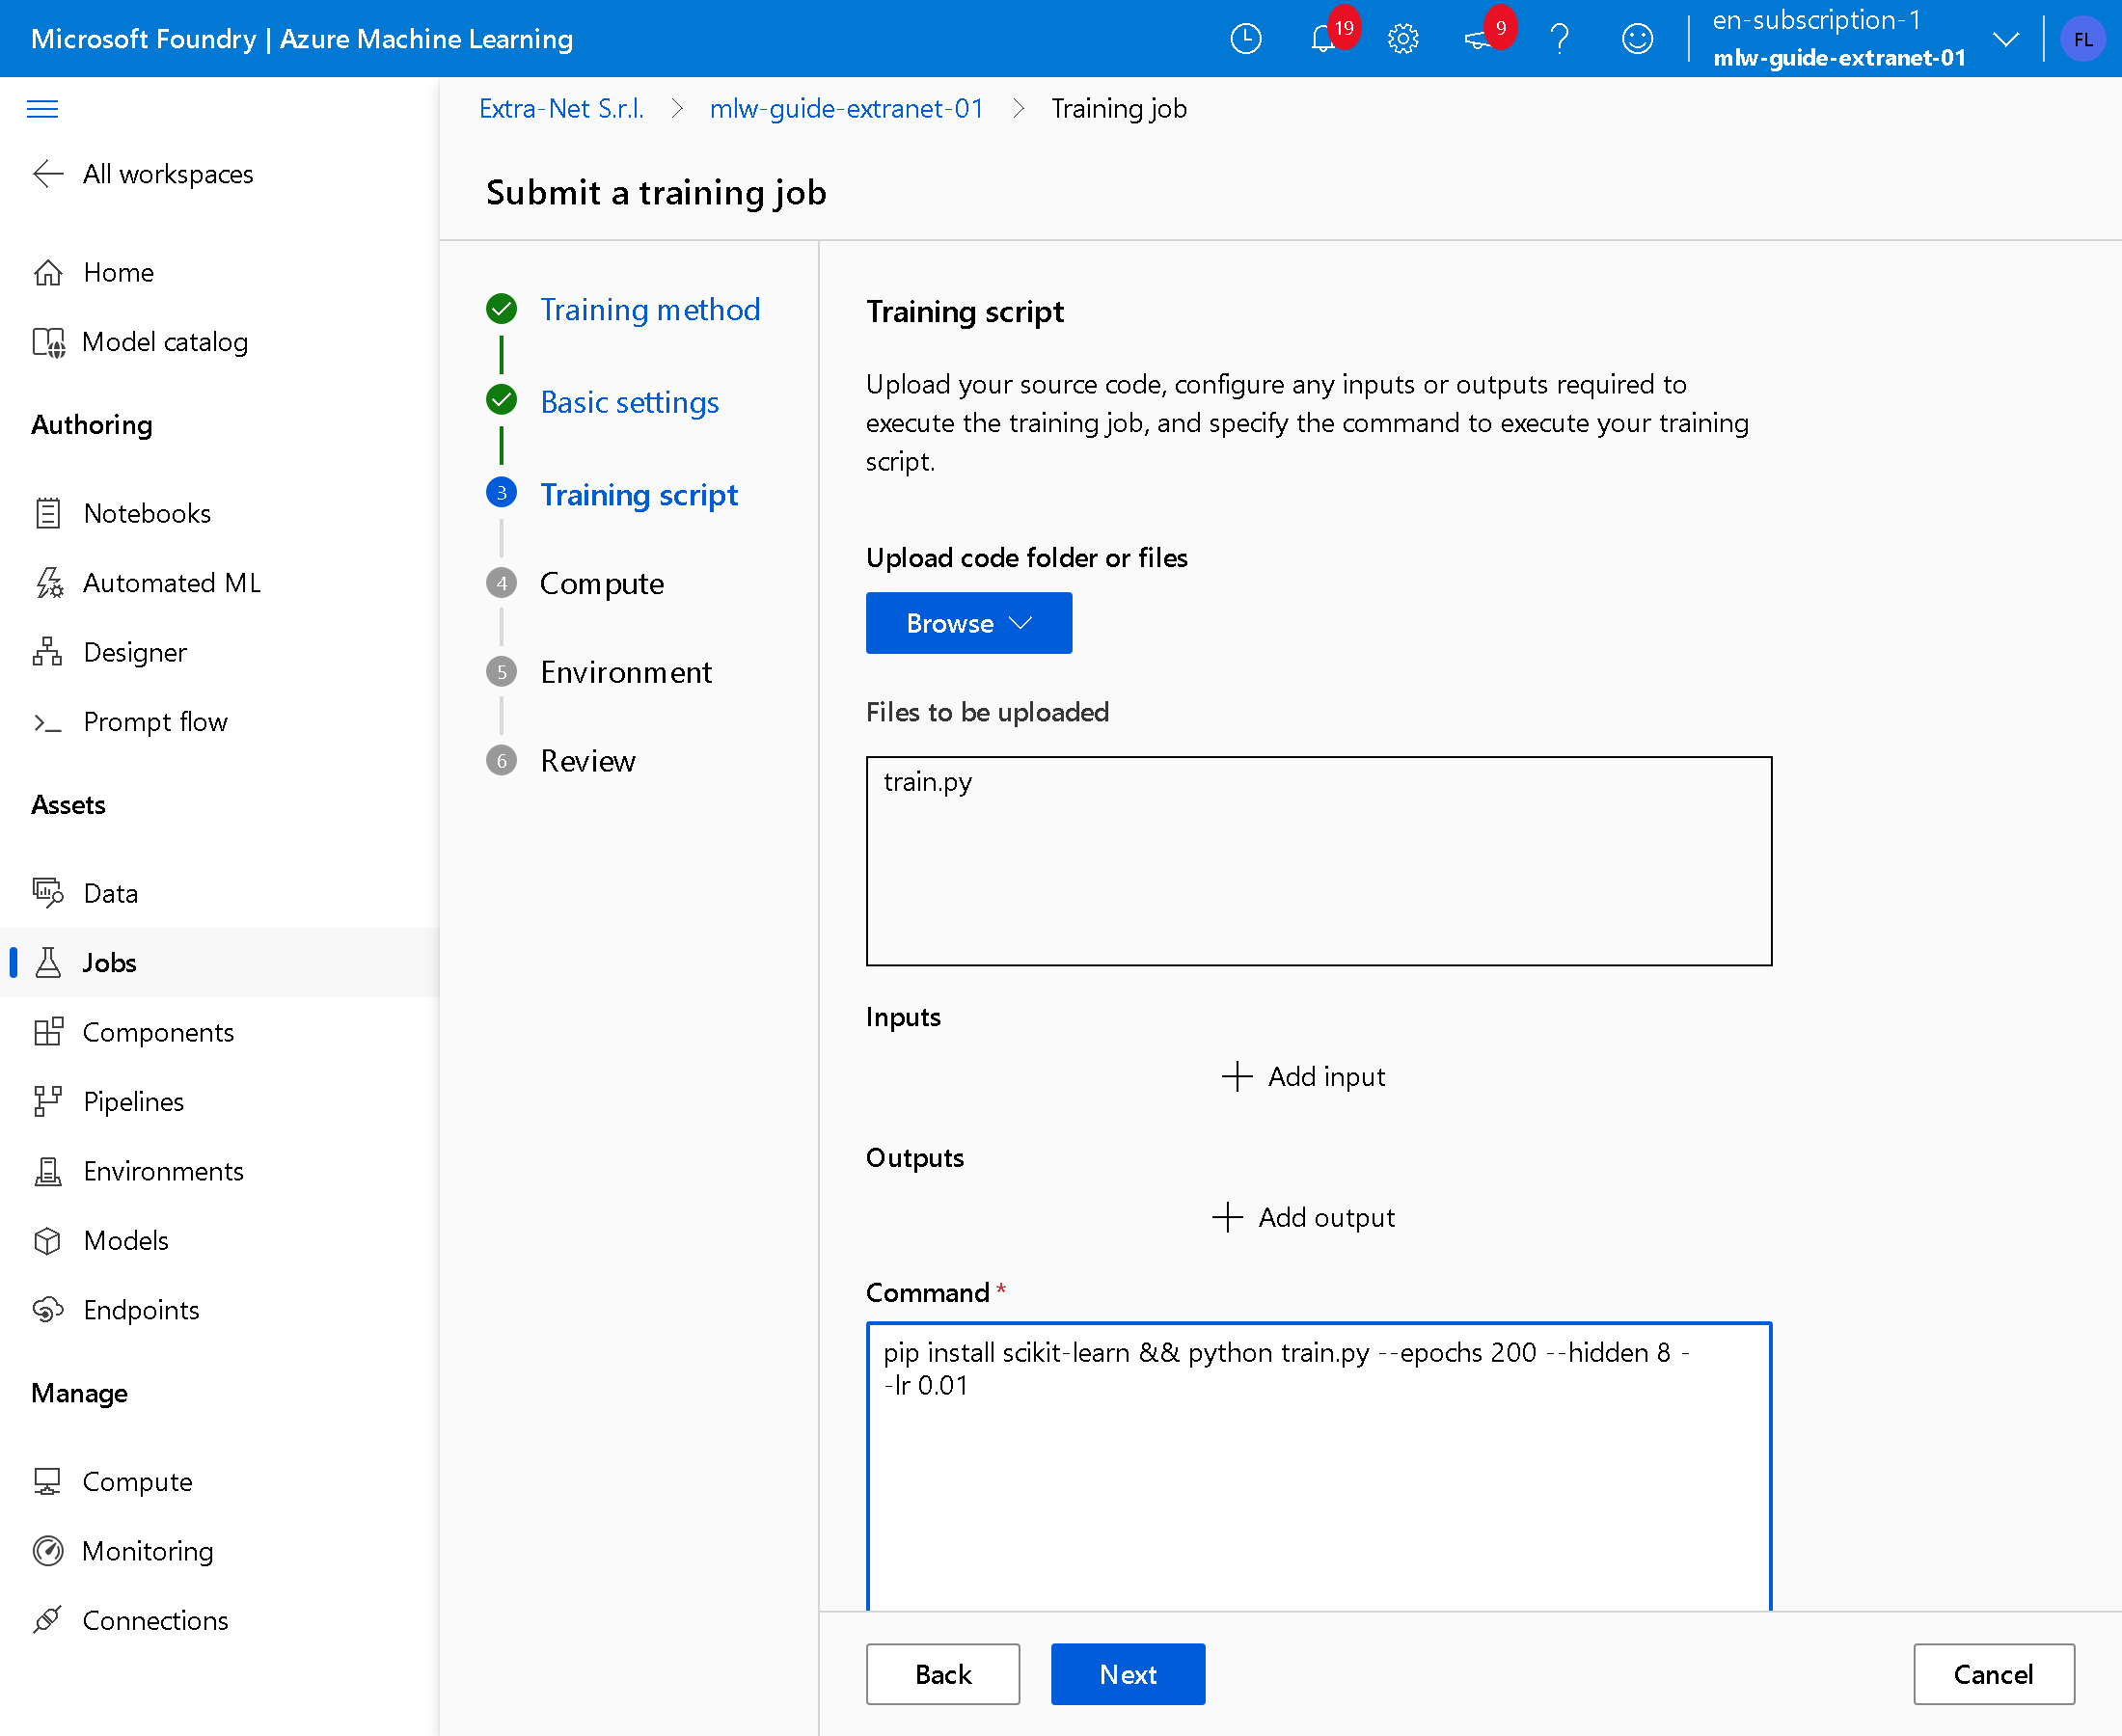
Premi Browse > Local files e scegli train.py. In Command scrivi:
pip install scikit-learn && python train.py --epochs 200 --hidden 8 --lr 0.01L'ambiente PyTorch scelto più avanti non contiene scikit-learn: lo installa la prima parte del comando. Premi Next.
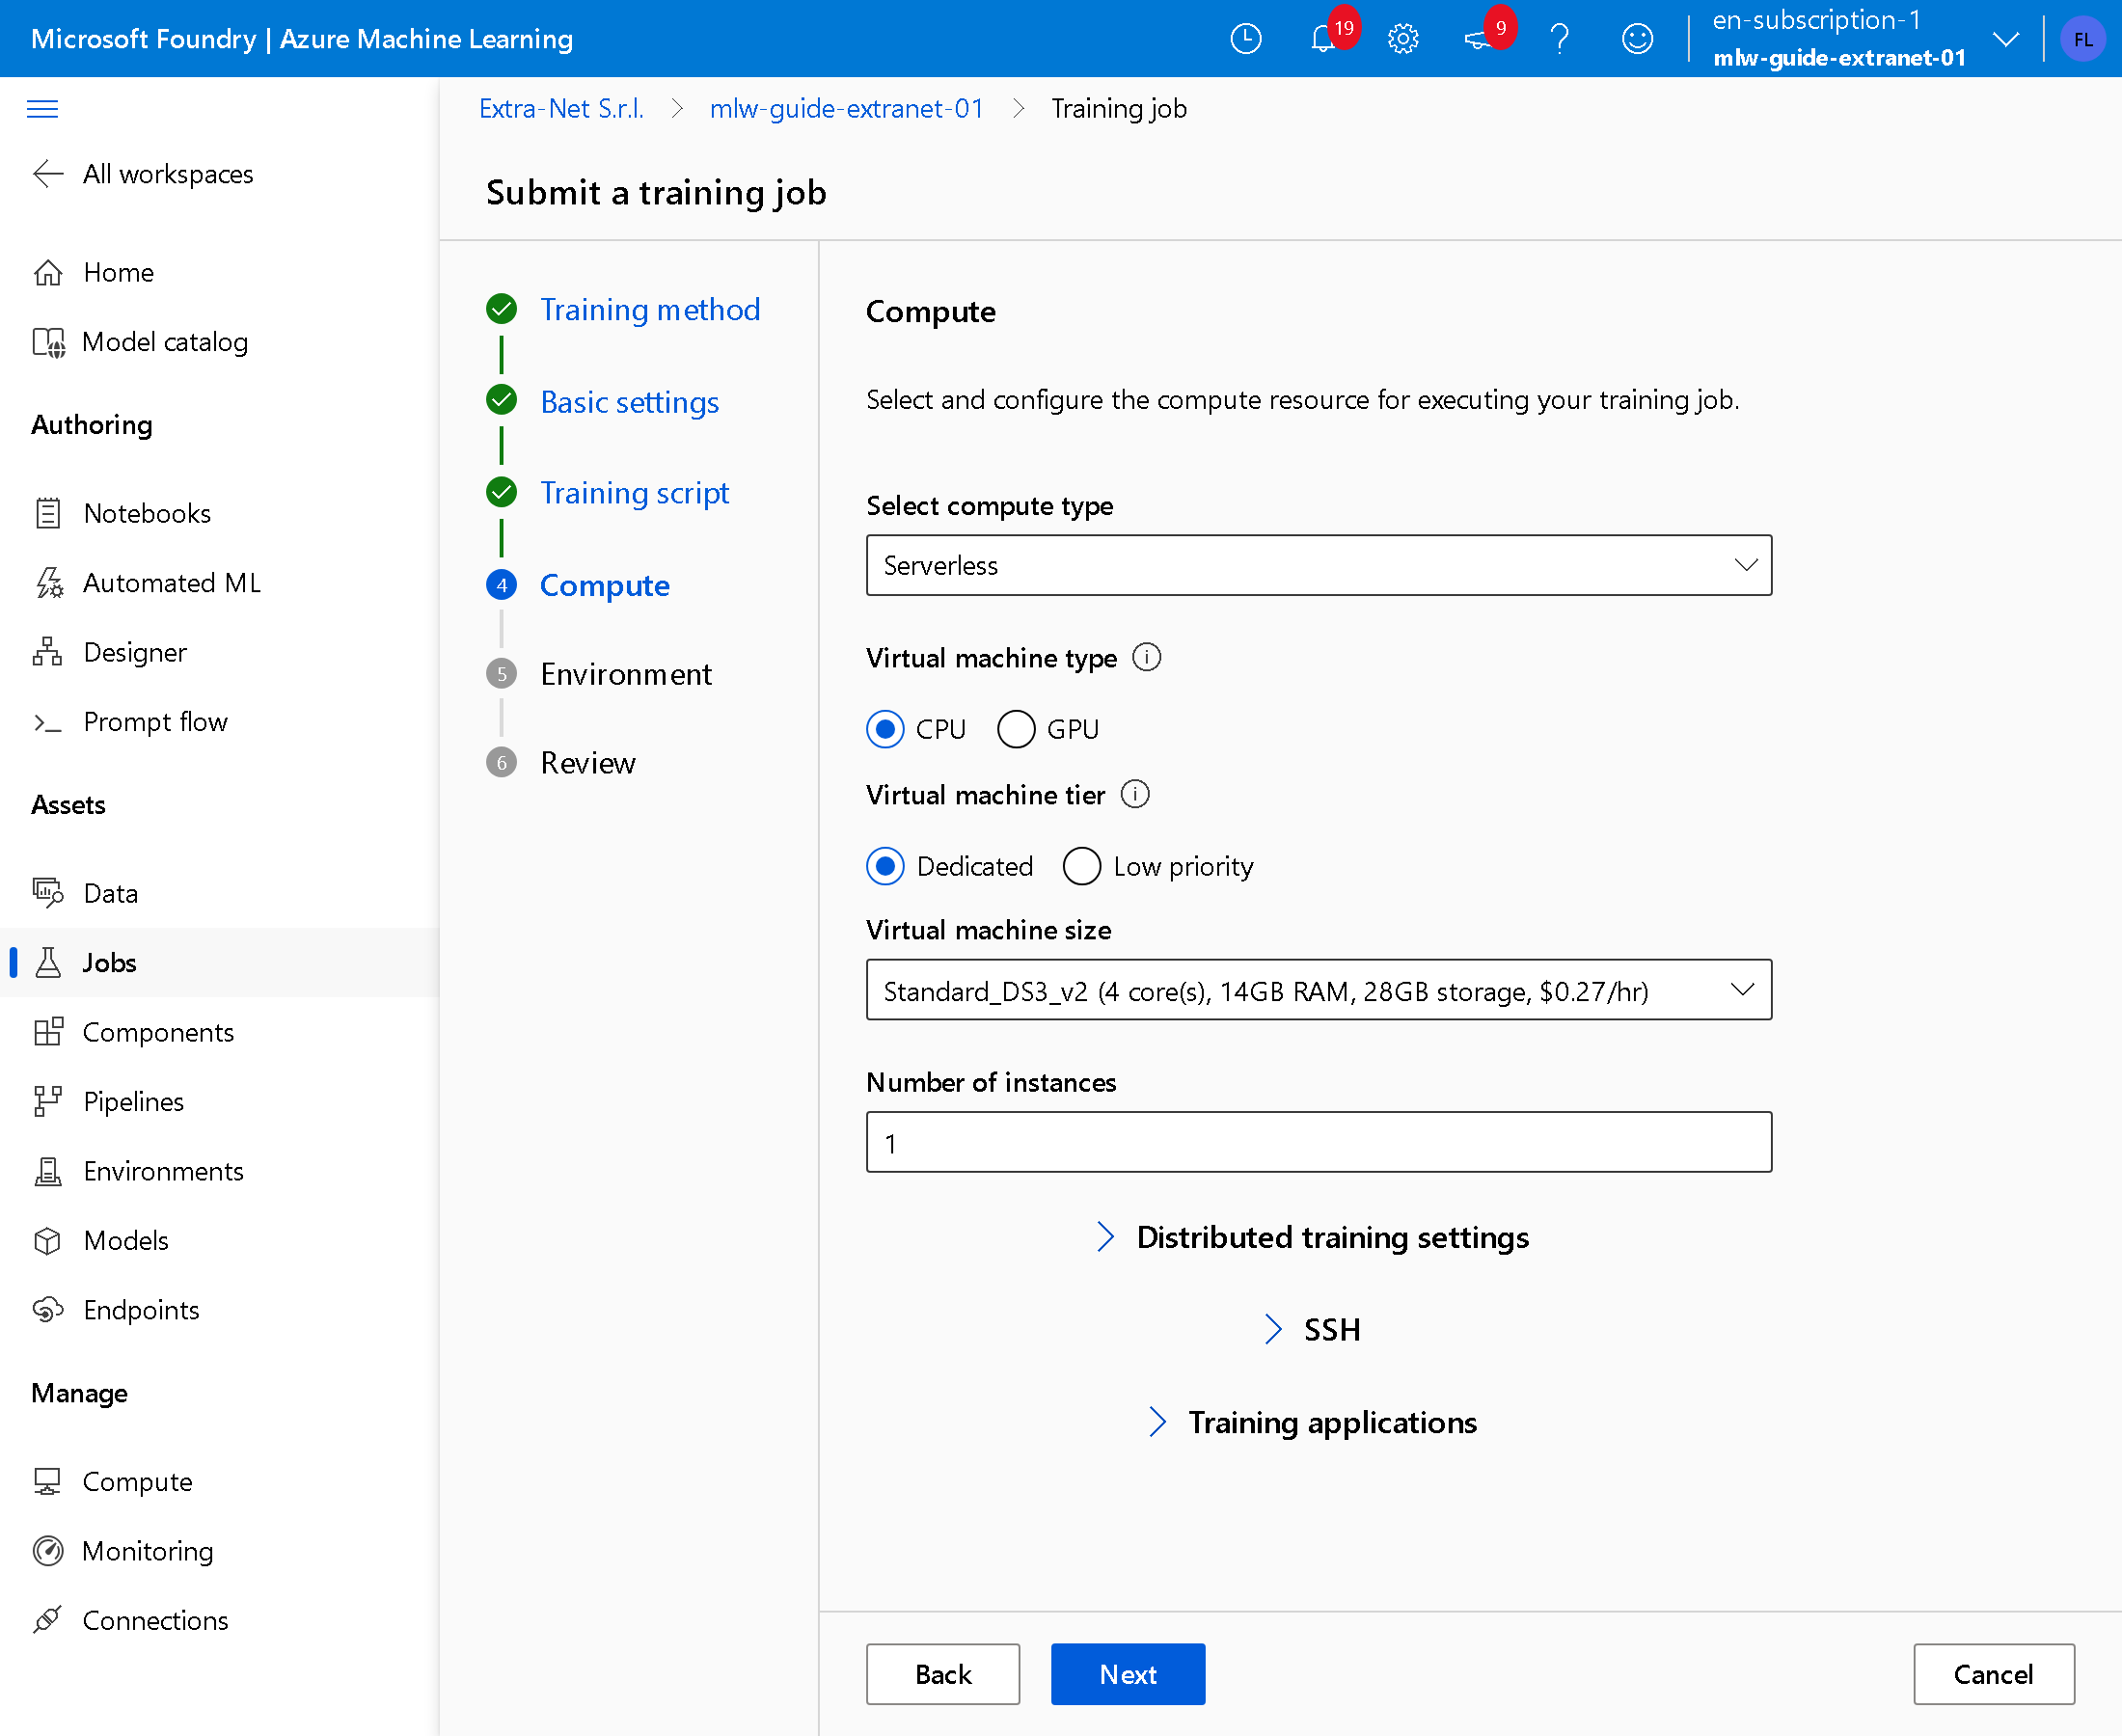
5. Scegli la macchina e l'ambiente
Lascia Serverless, CPU, Dedicated e la macchina proposta, Standard_DS3_v2. Azure la accende per l'addestramento e la spegne alla fine. Premi Next.
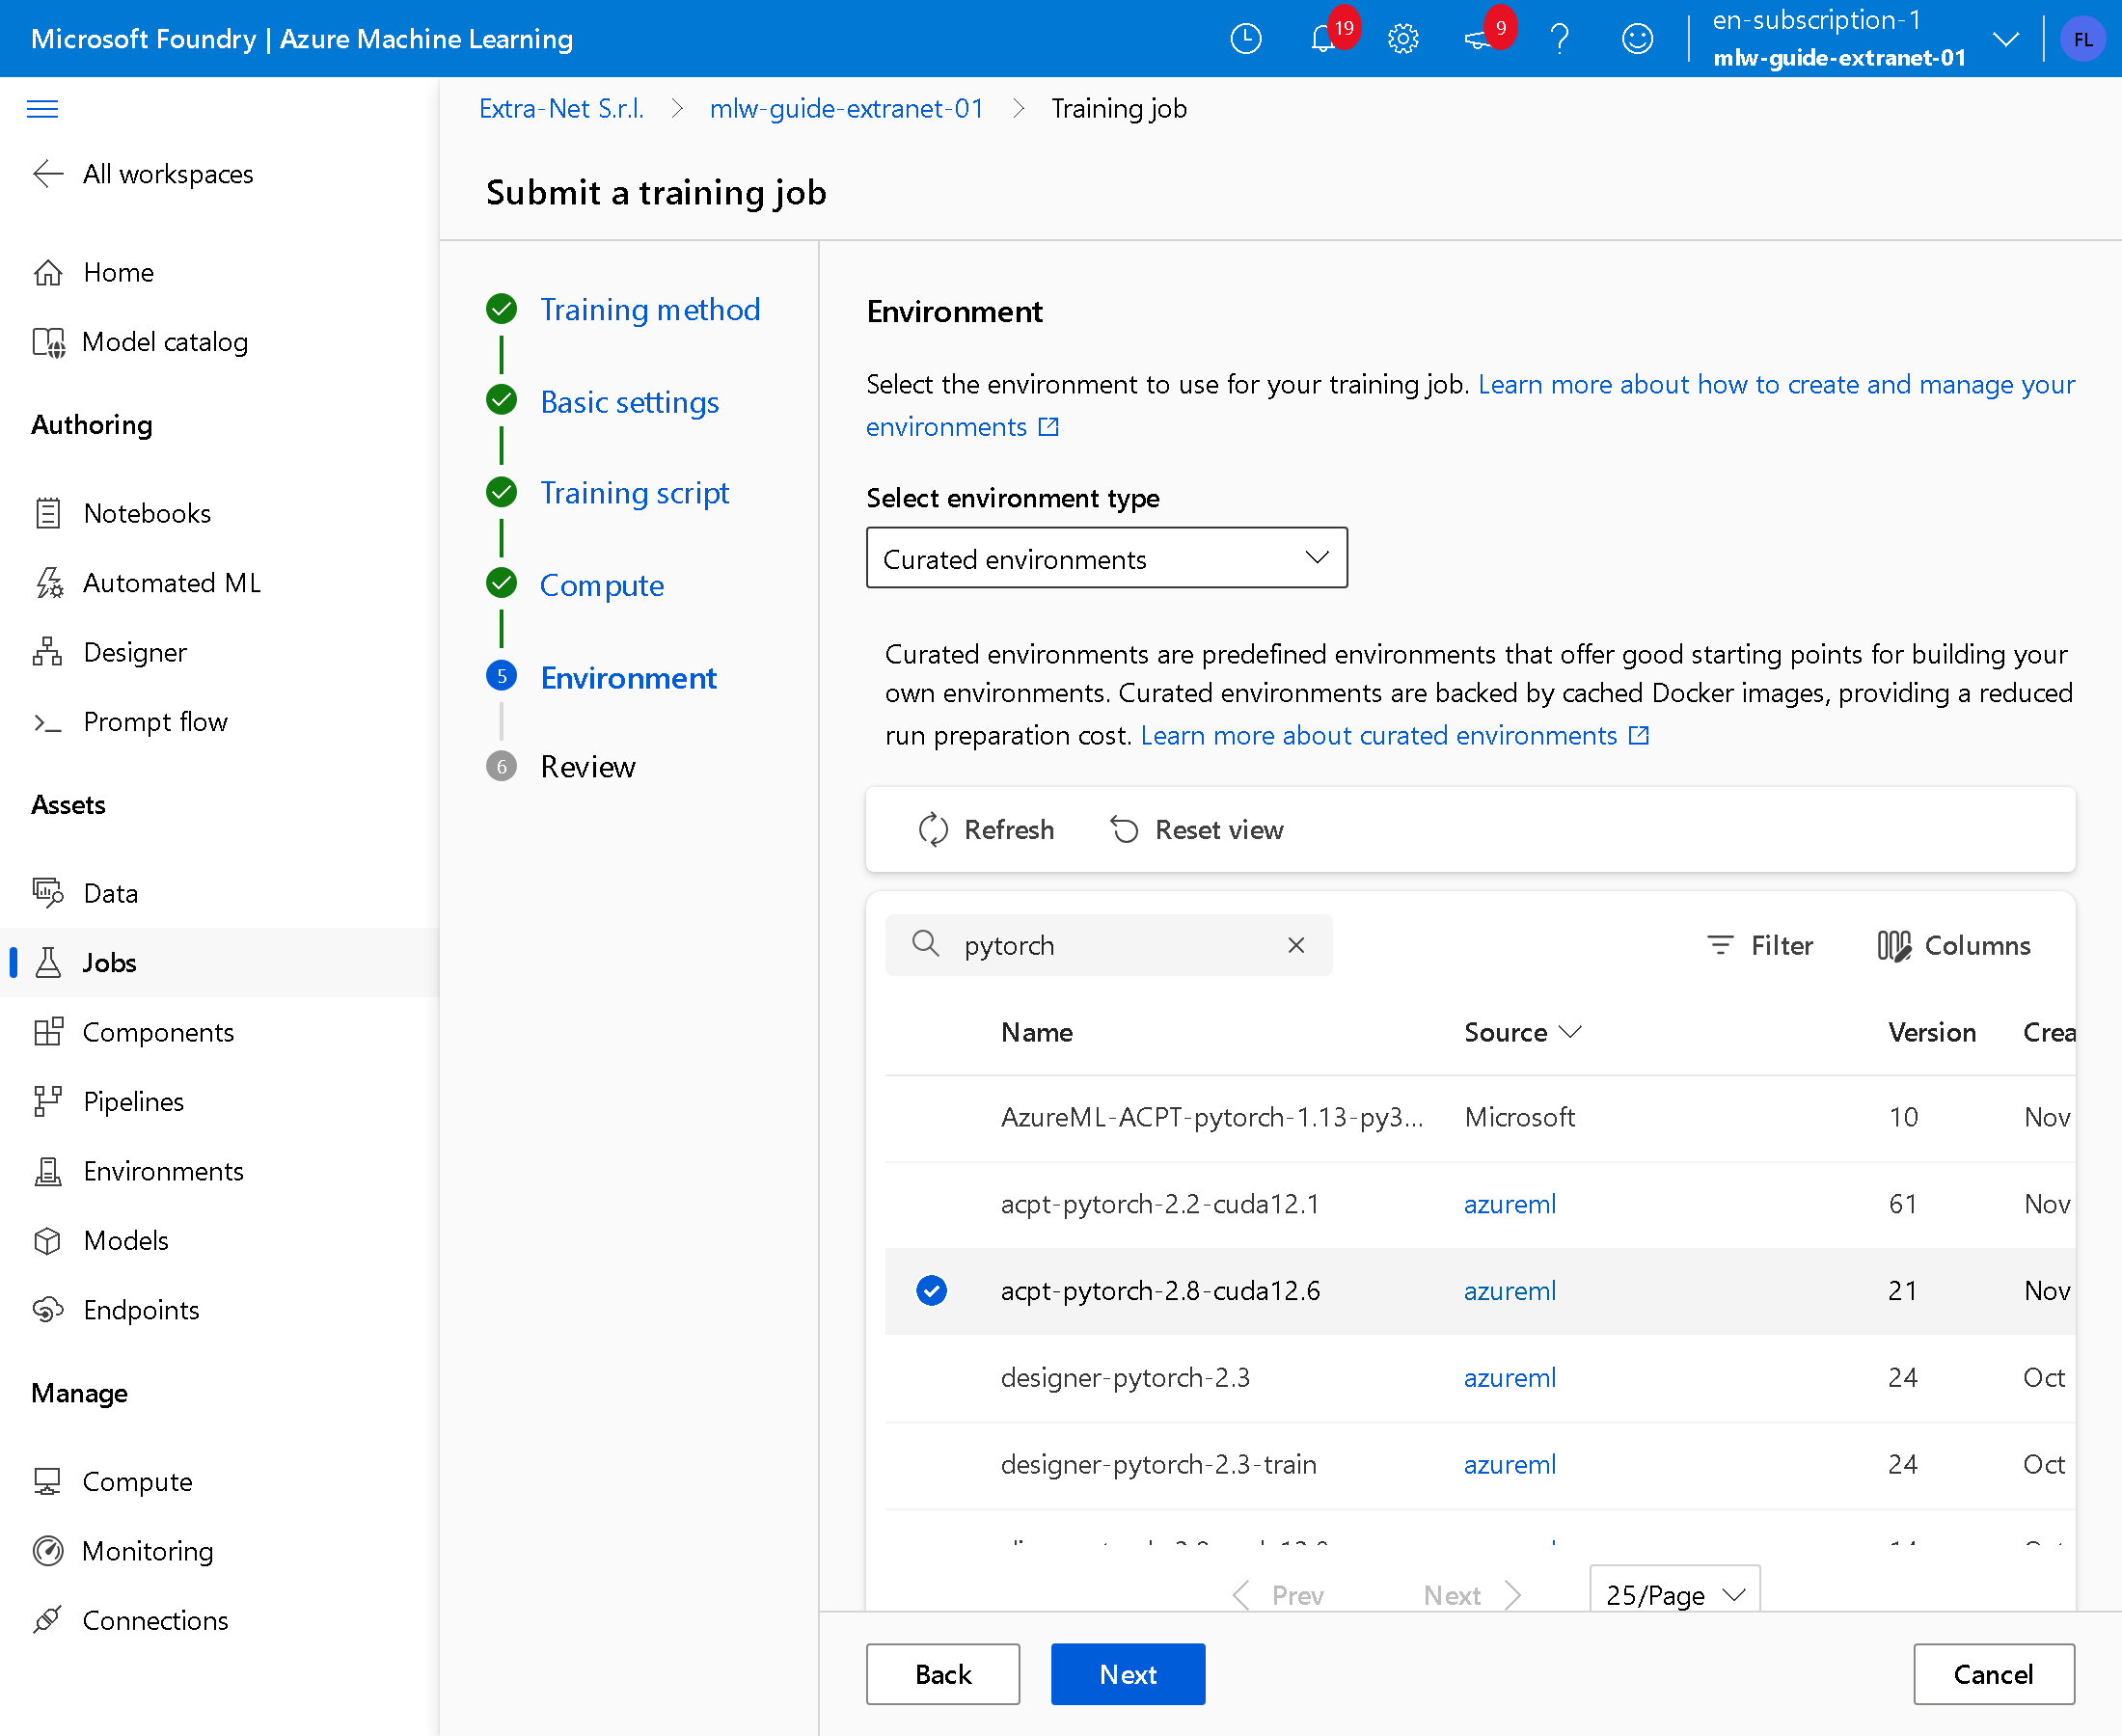
In Curated environments cerca pytorch, seleziona acpt-pytorch-2.8-cuda12.6 e premi Next.
Controlla il riepilogo e premi Submit training job.
6. Leggi l'esito
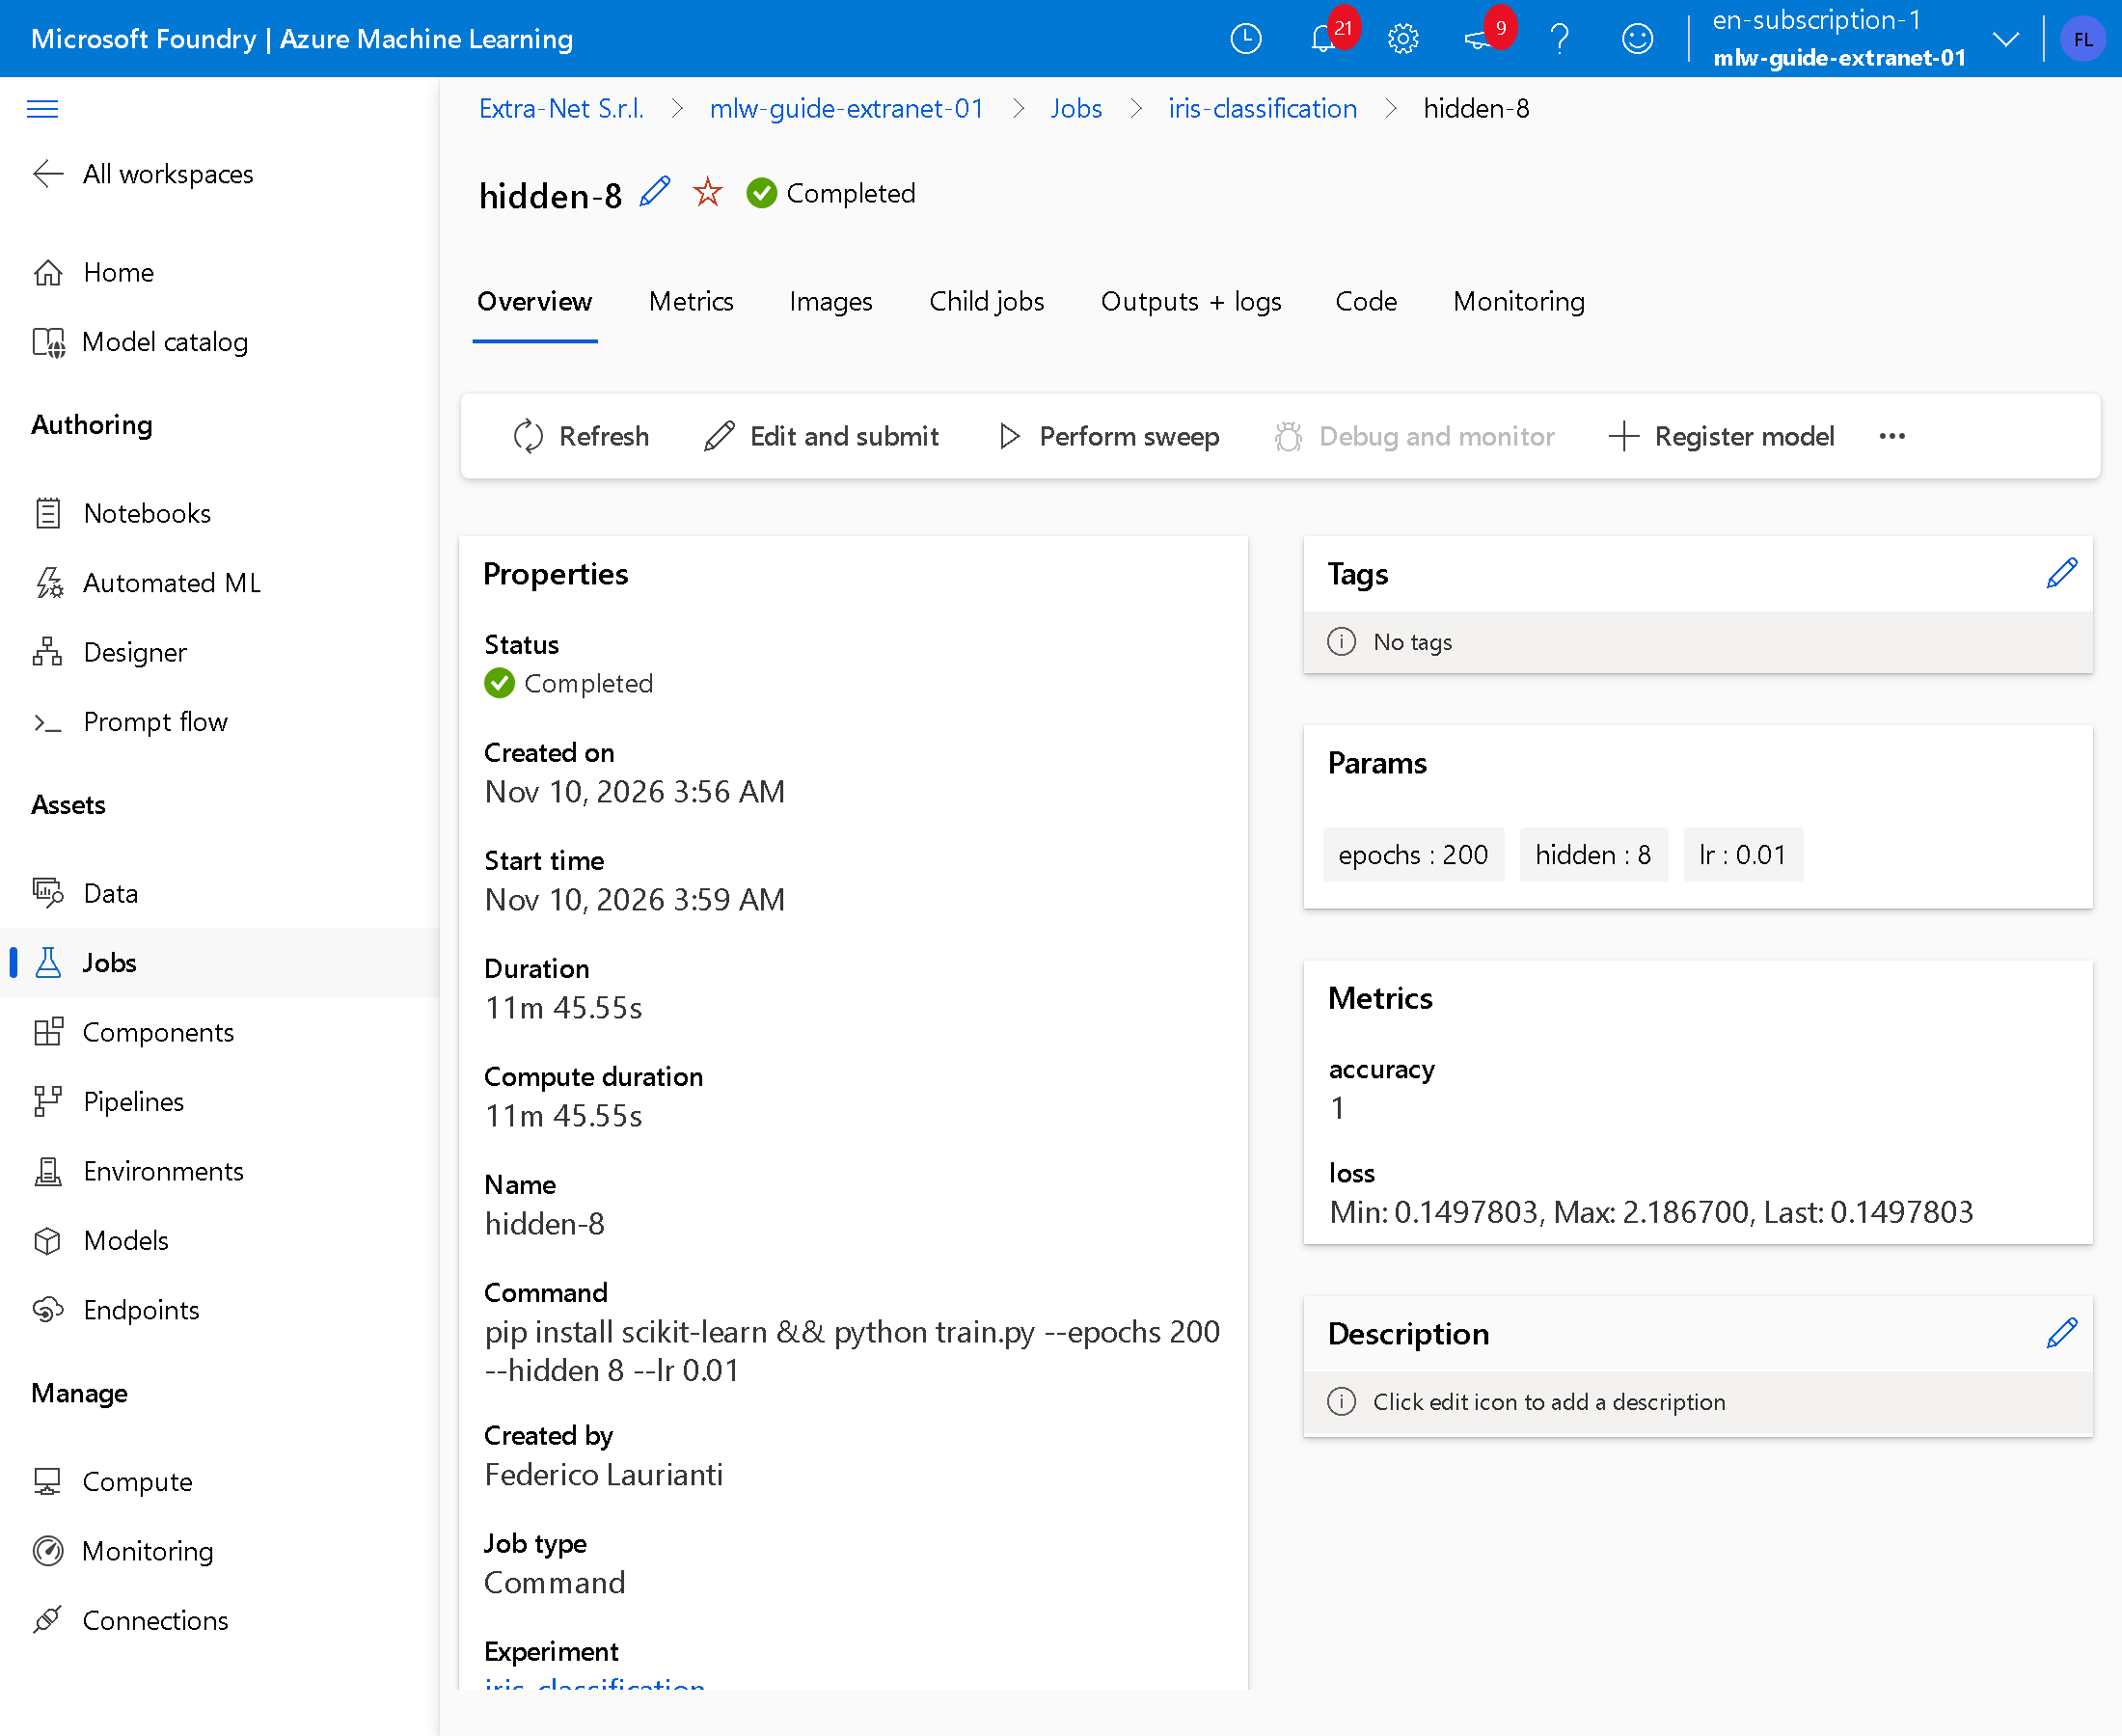
Nella prova l'addestramento è rimasto in coda poco più di due minuti ed è durato dodici, quasi tutti per preparare la macchina e l'ambiente. Al termine lo stato è Completed e a destra compaiono i parametri e le metriche: accuracy 1, cioè tutti i 45 fiori di prova riconosciuti.
7. Confronta un secondo addestramento
Ripeti i passi 4 e 5 con Job name hidden-2, di nuovo iris-classification in New experiment name, così lo studio lo aggiunge allo stesso esperimento, e questo comando, che usa una rete più piccola e un addestramento più breve:
pip install scikit-learn && python train.py --epochs 30 --hidden 2 --lr 0.001Quando è finito, apri l'esperimento iris-classification, premi Columns, aggiungi accuracy e hidden e premi Save. Le due colonne si aggiungono in fondo alla tabella: scorrila verso destra.
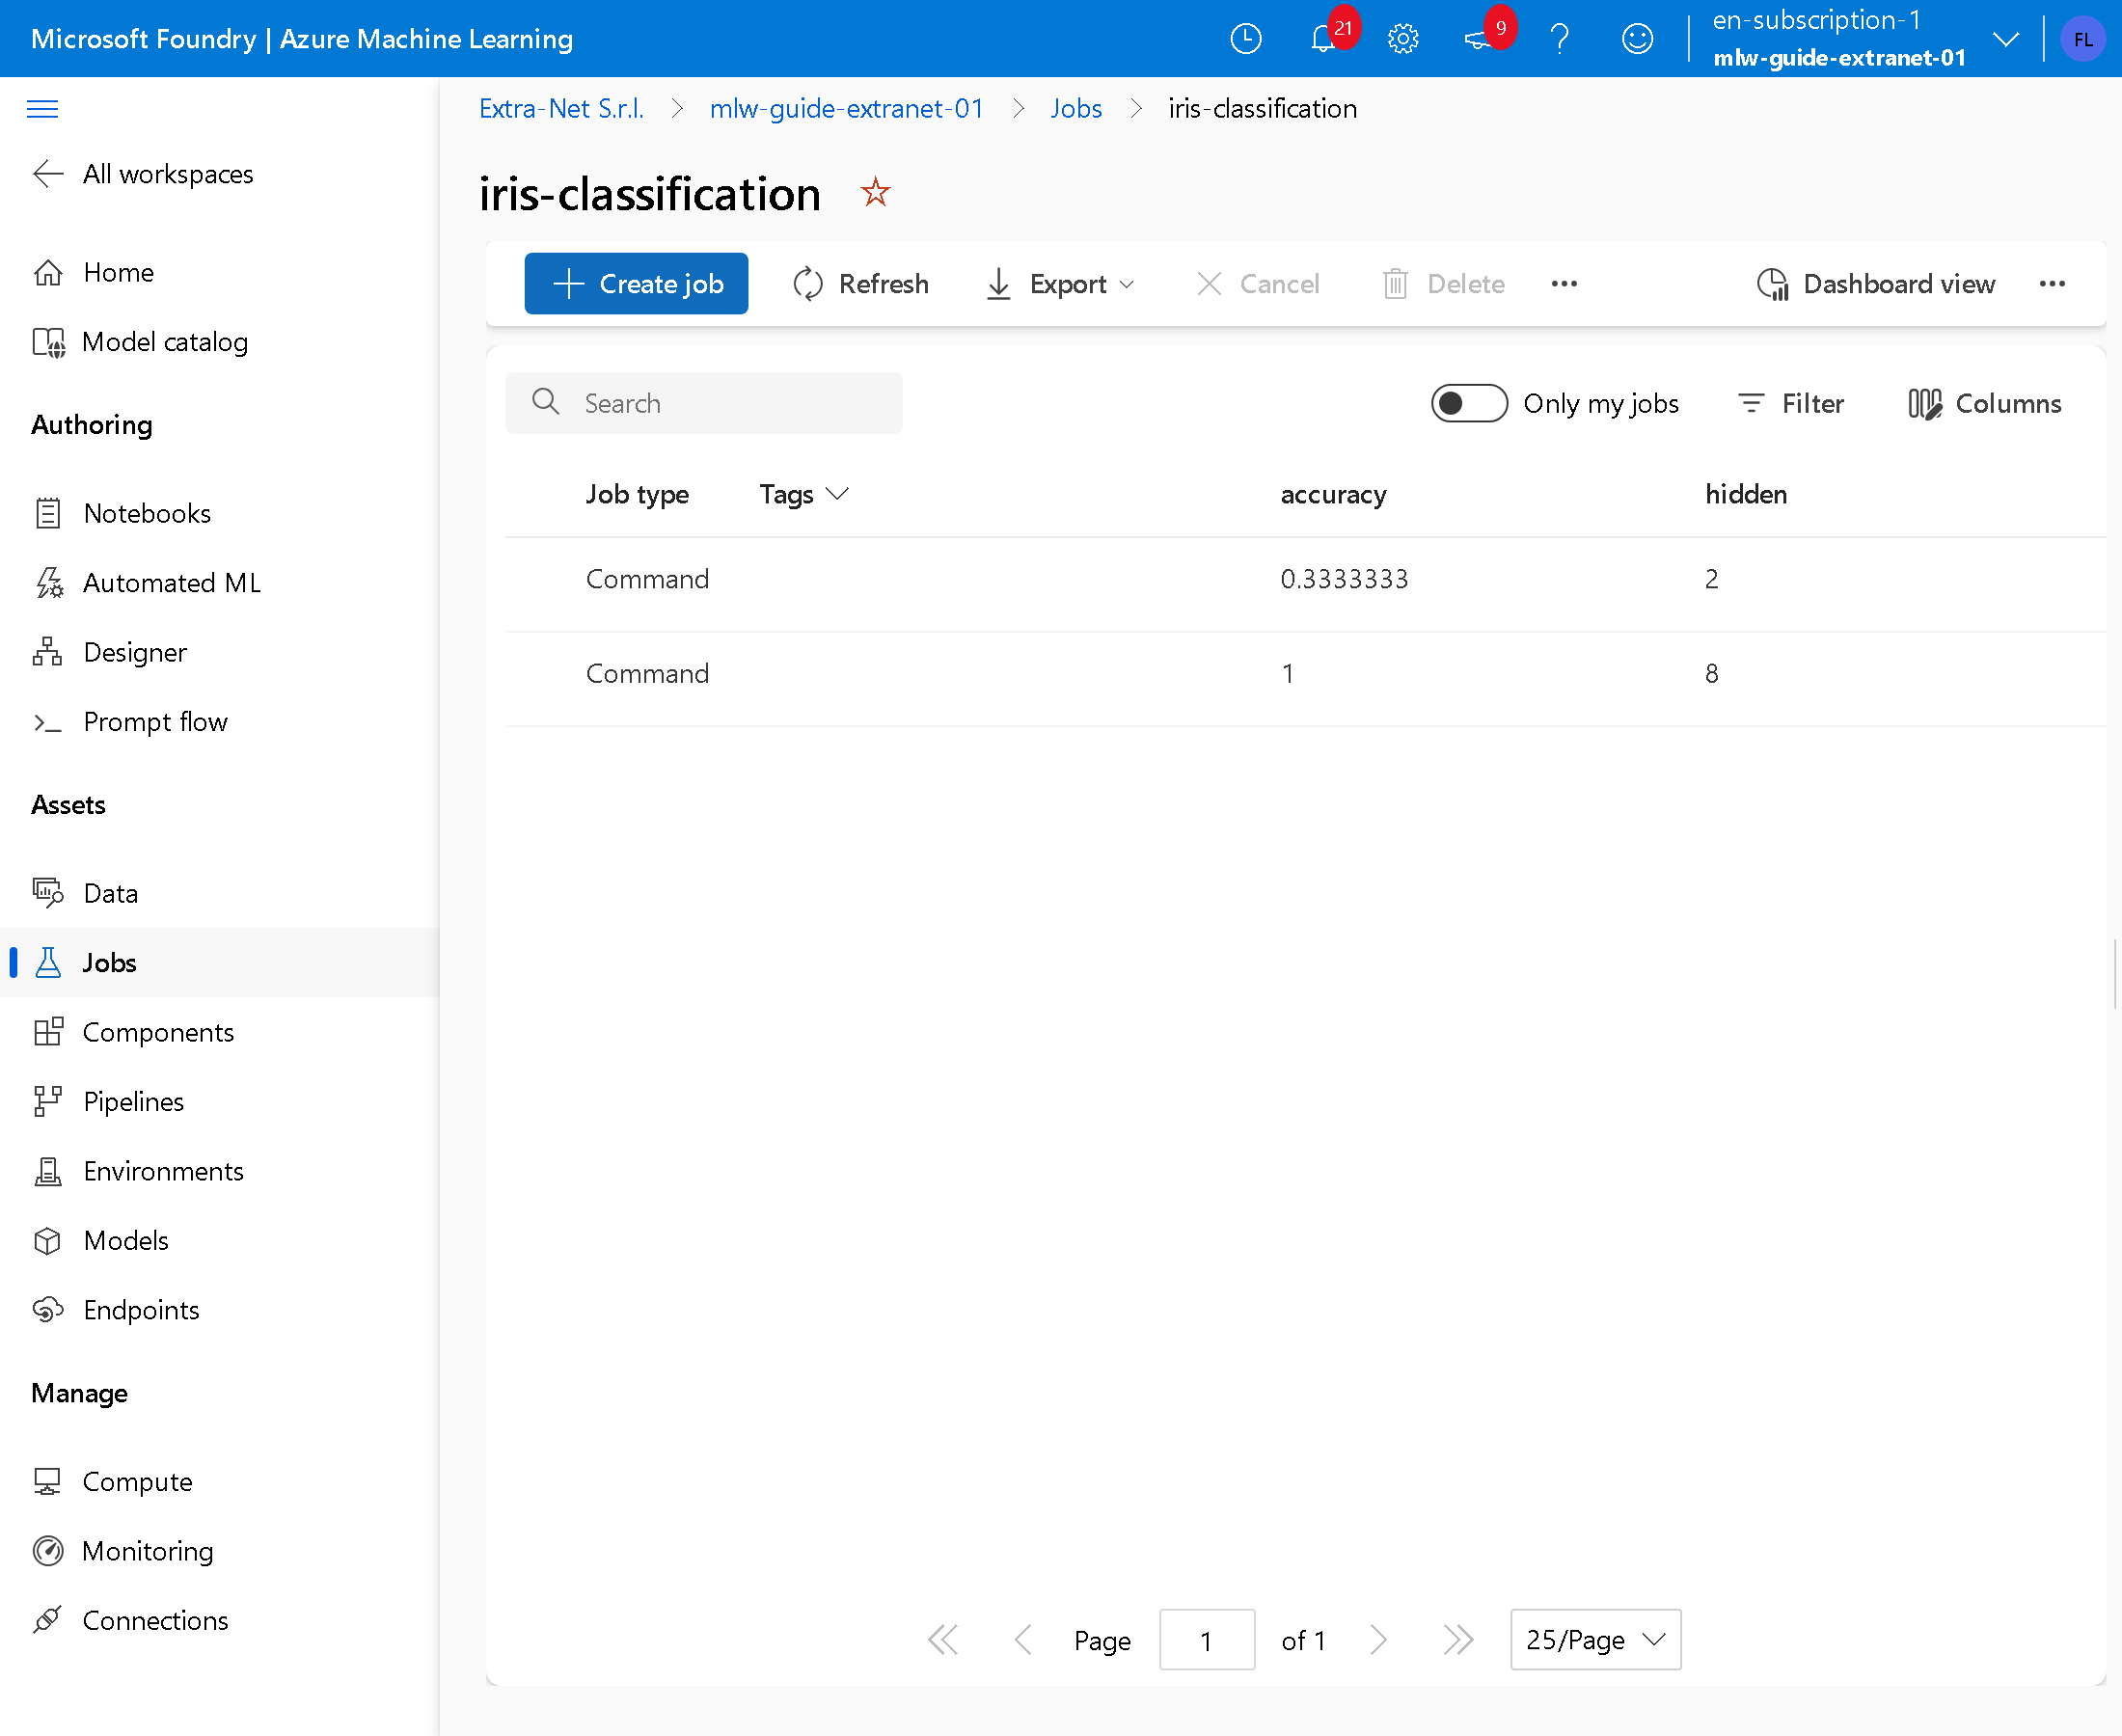
La rete con 2 neuroni riconosce un fiore su tre, come tirando a caso; quella con 8 li riconosce tutti.
Il modello
8. Registra le due versioni
Apri l'addestramento hidden-2 e premi Register model. Lo studio trova da solo la cartella model in formato MLflow.
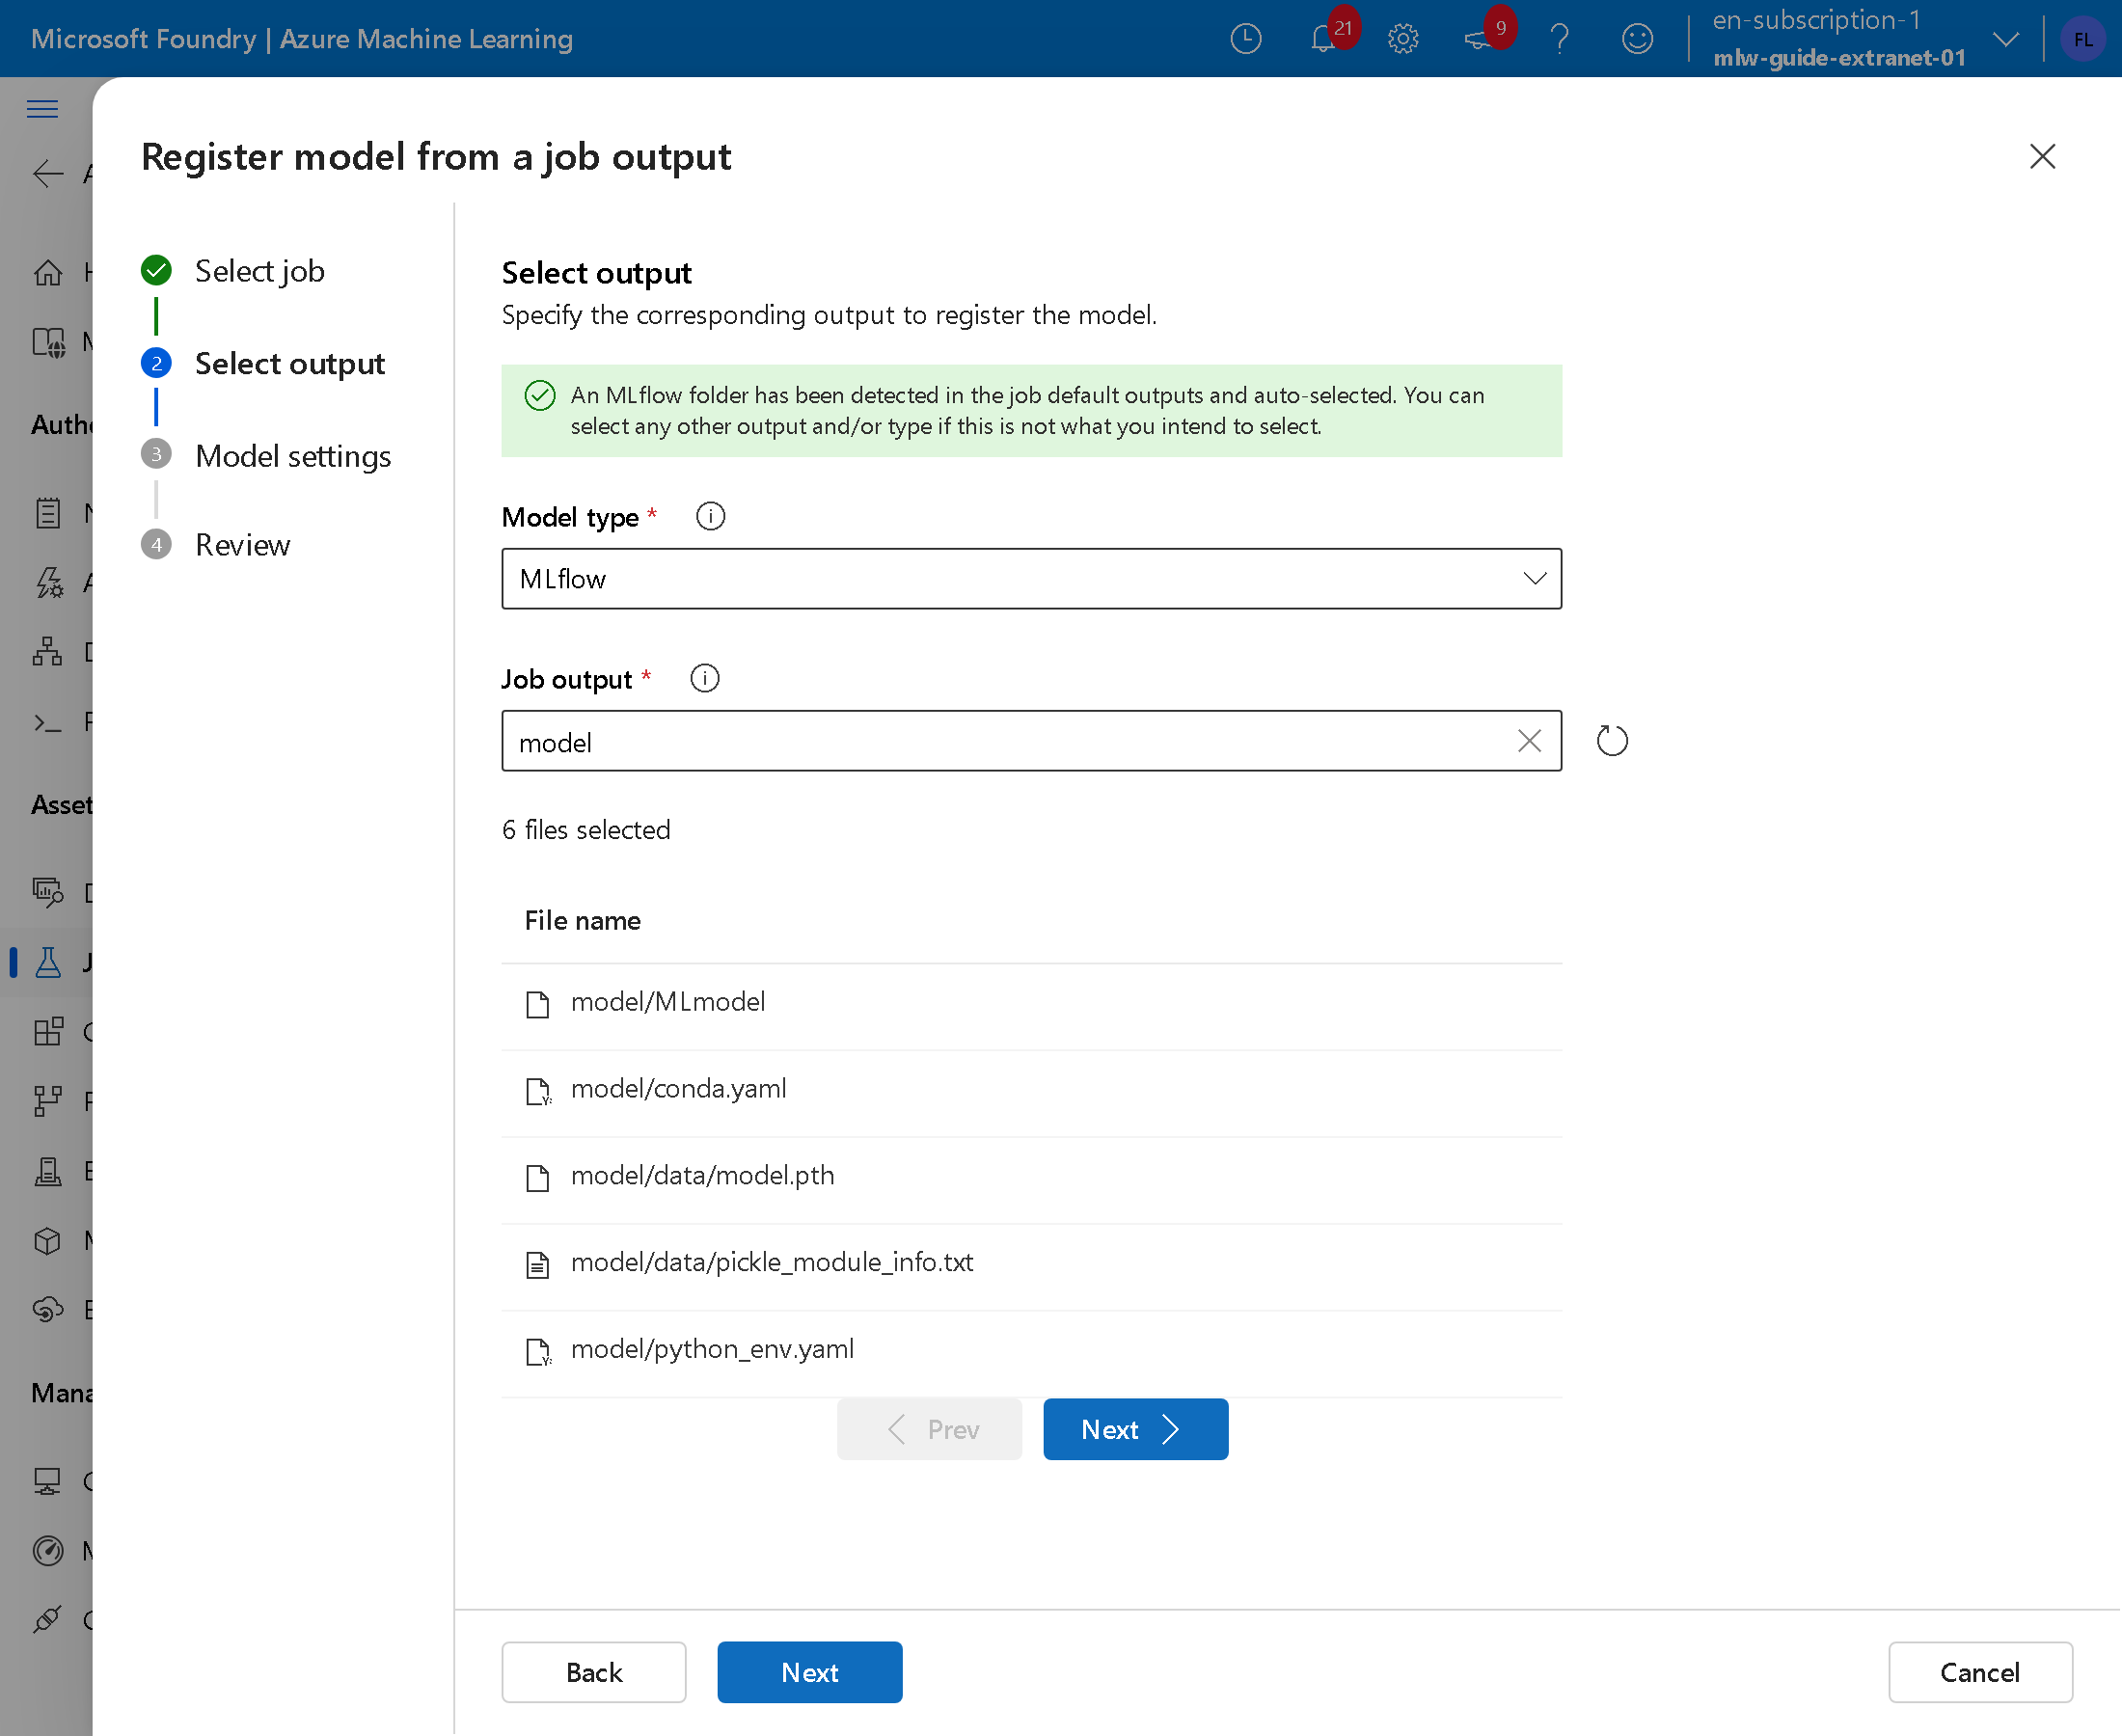
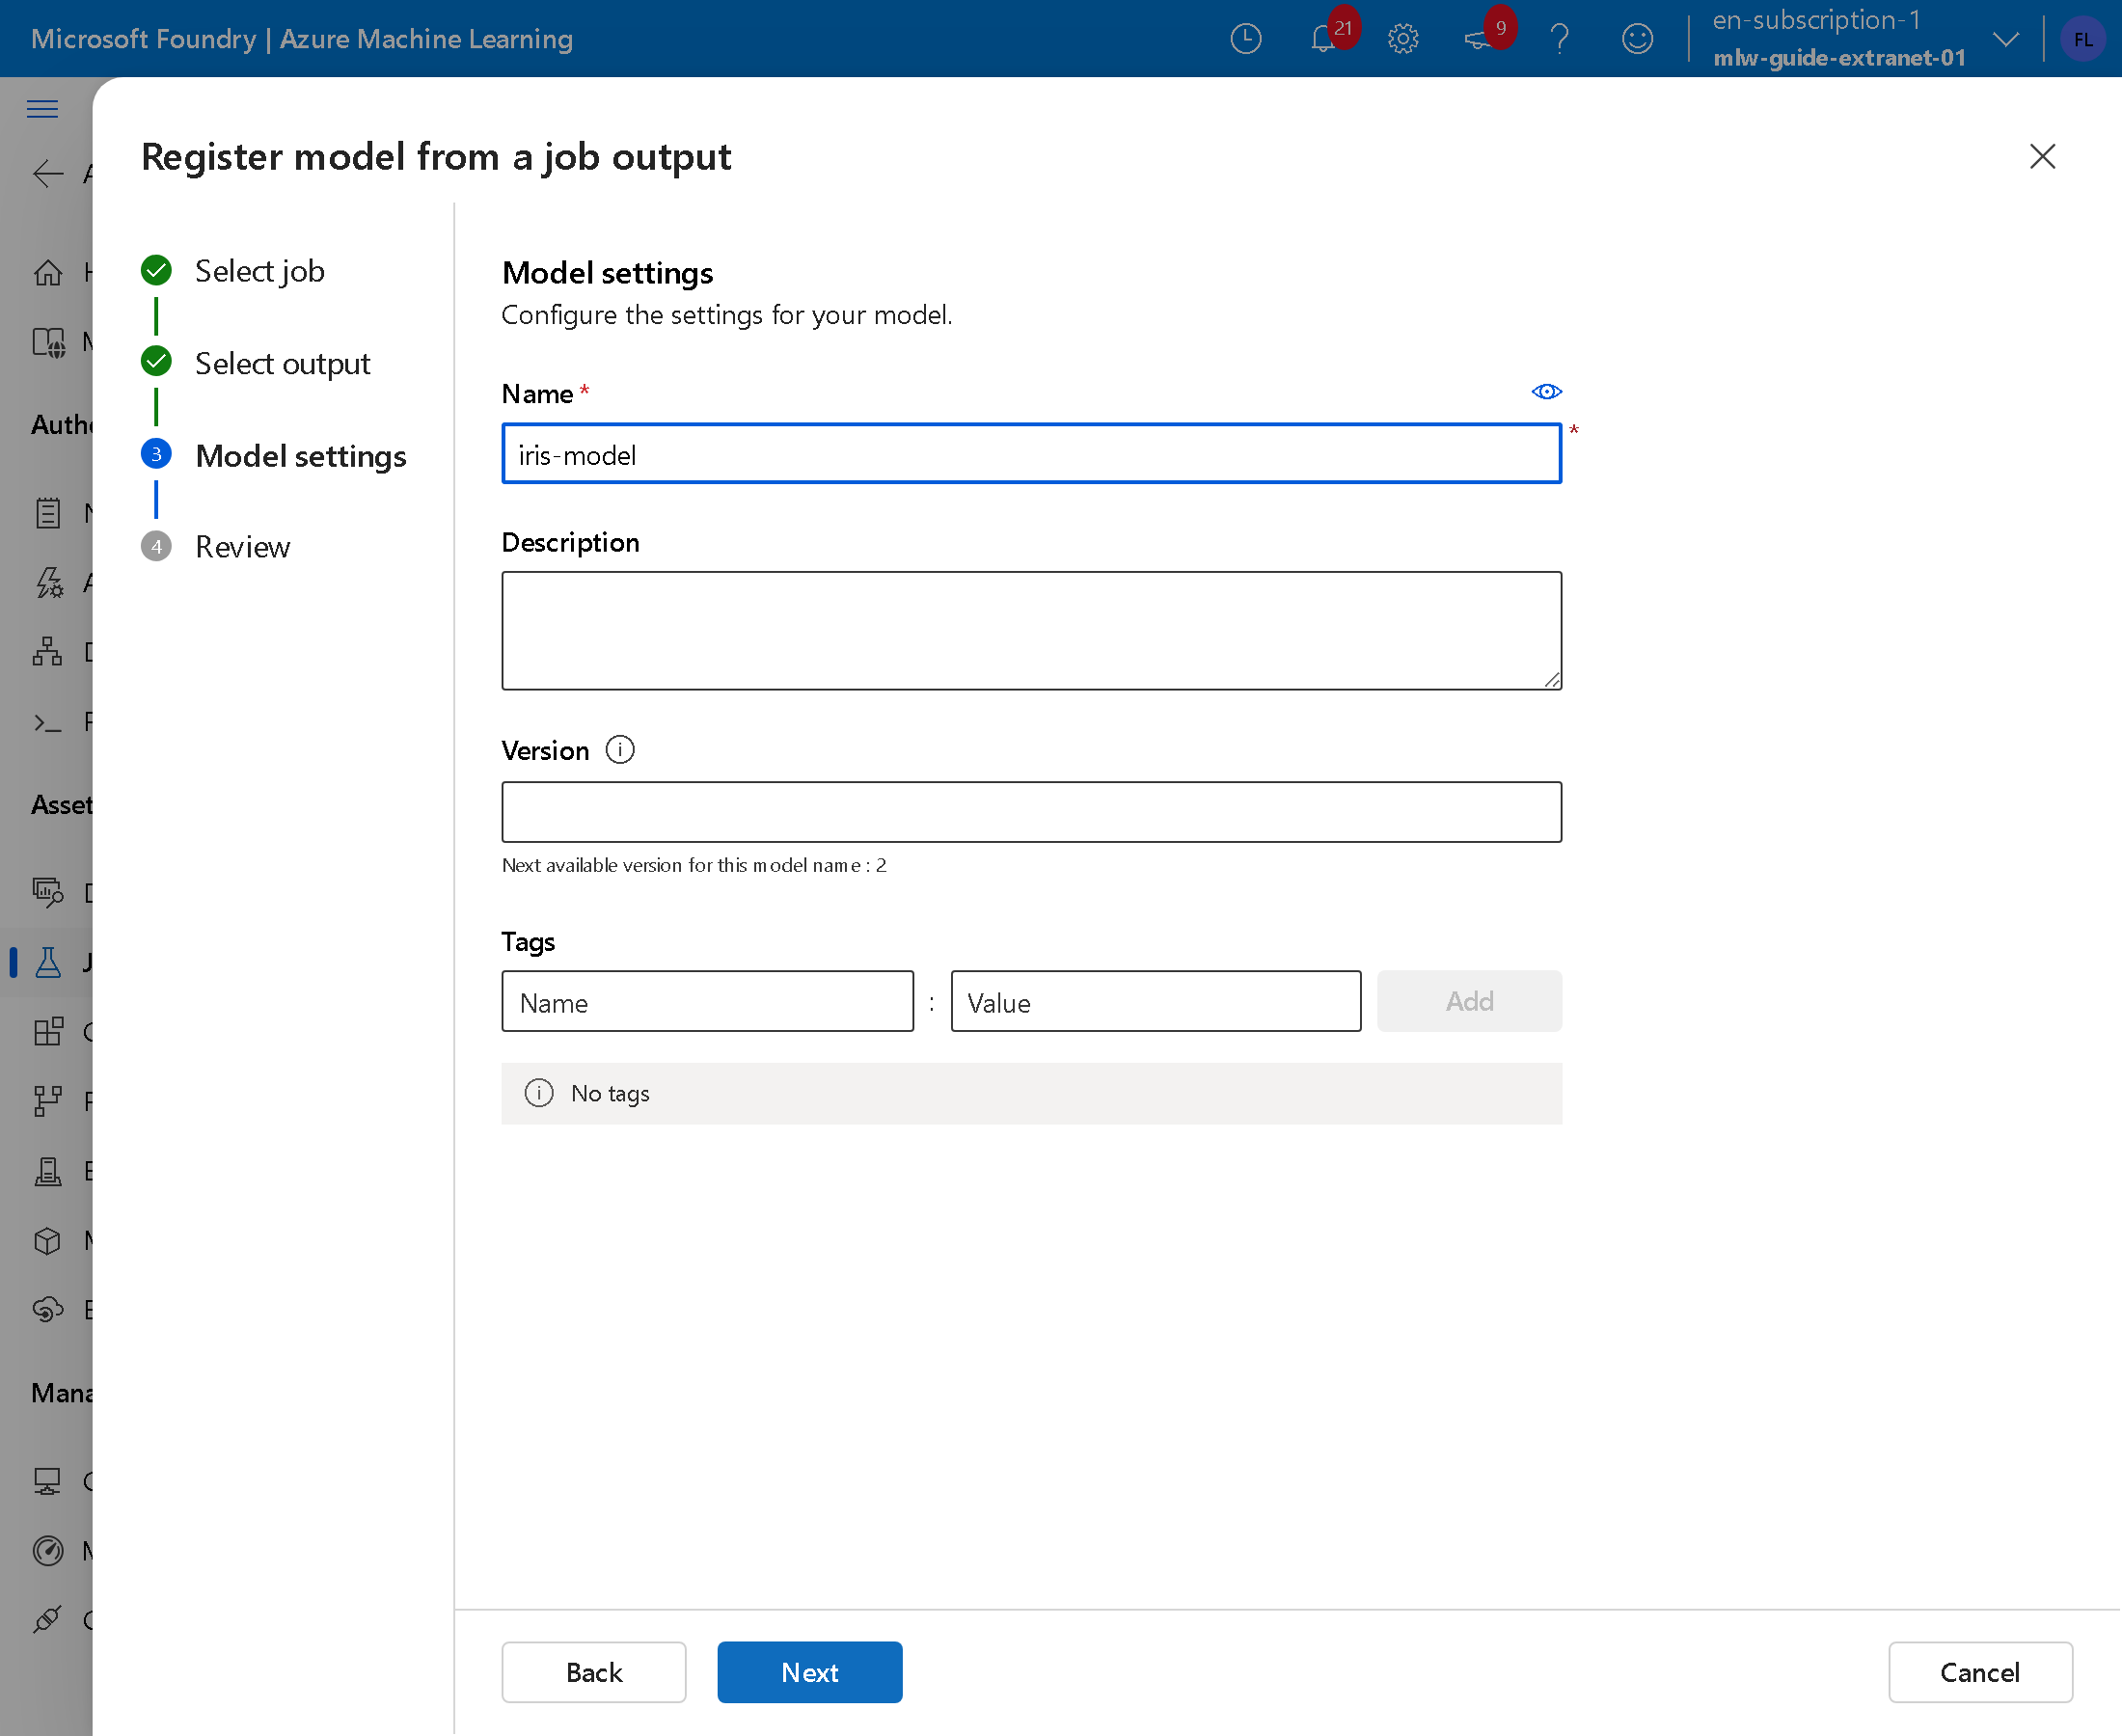
Premi Next, in Name scrivi iris-model, premi Next e Register: è la versione 1.
Ripeti dall'addestramento hidden-8 con lo stesso nome: lo studio propone la versione 2.
La pubblicazione
9. Pubblica la versione 2
Apri Models > iris-model, versione 2, premi Use this model > Real-time endpoint. Lo studio avvisa che lo script di inferenza e l'ambiente vengono generati da soli.
Compila:
- Instance count:
1. La procedura ne propone 3, e nella prova la quota della sottoscrizione non bastava. - Virtual machine:
Standard_D2as_v4 - Endpoint name: un nome tuo, unico nella regione, qui
iris-guide-extranet-01
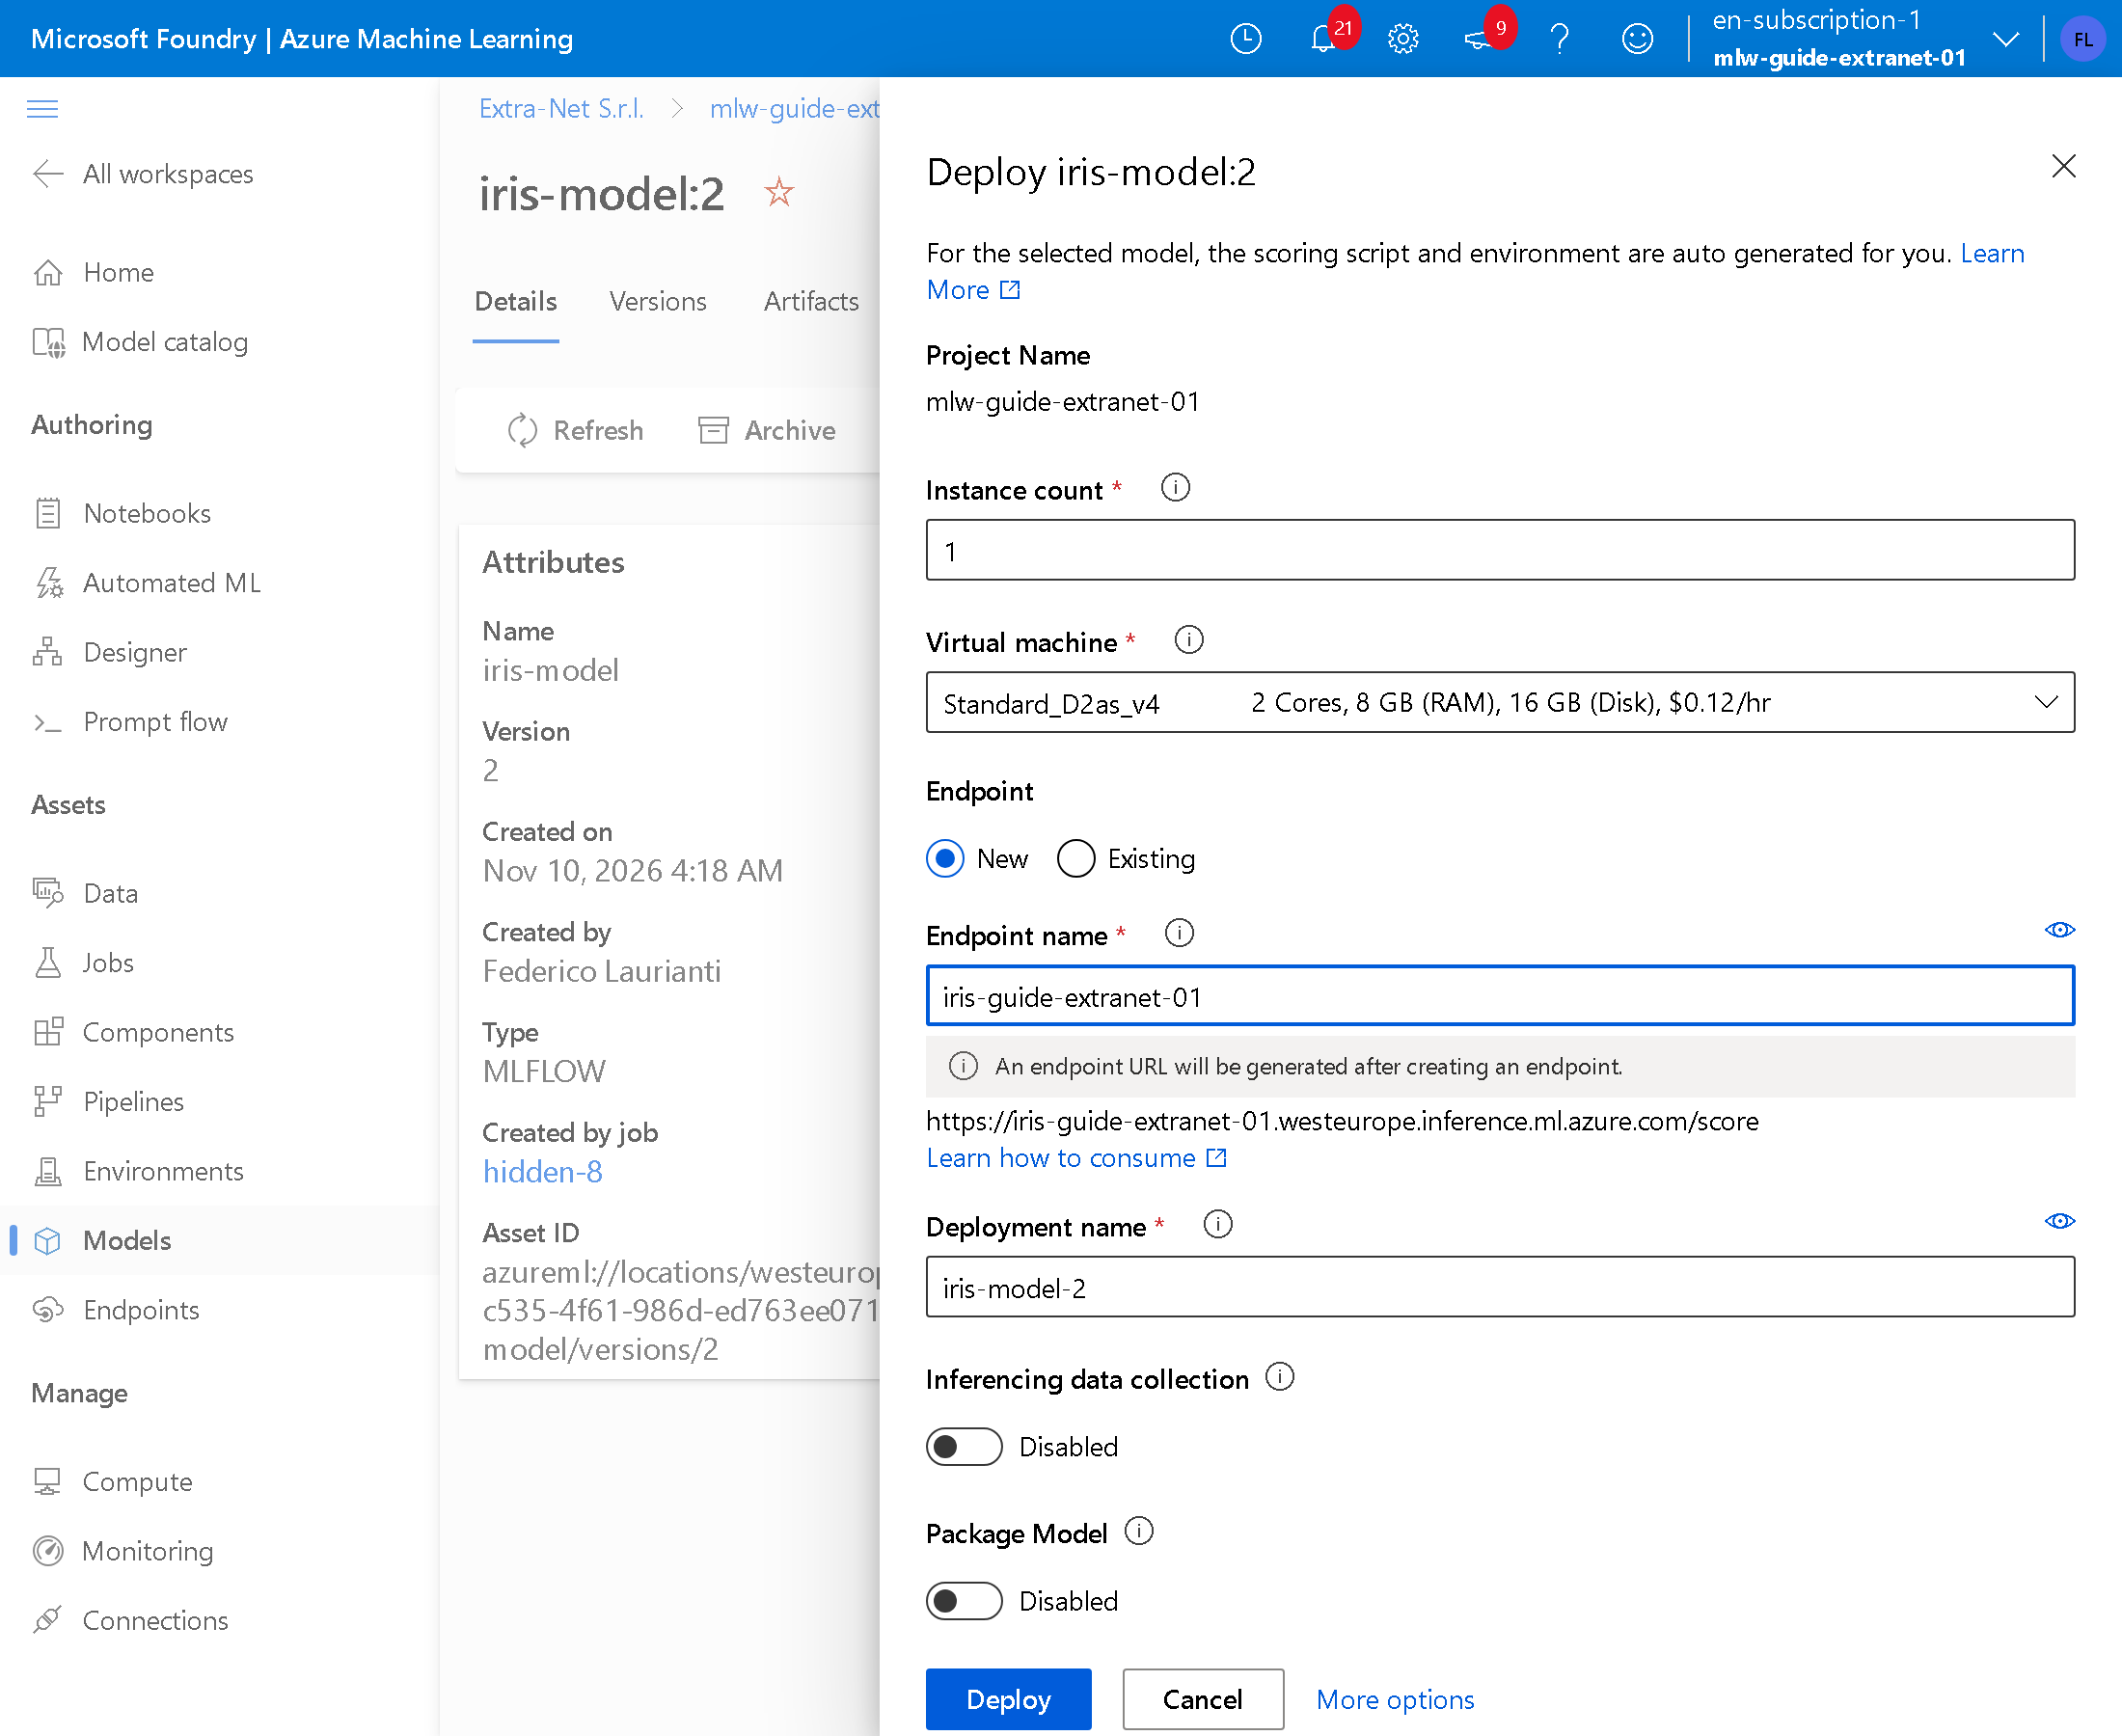
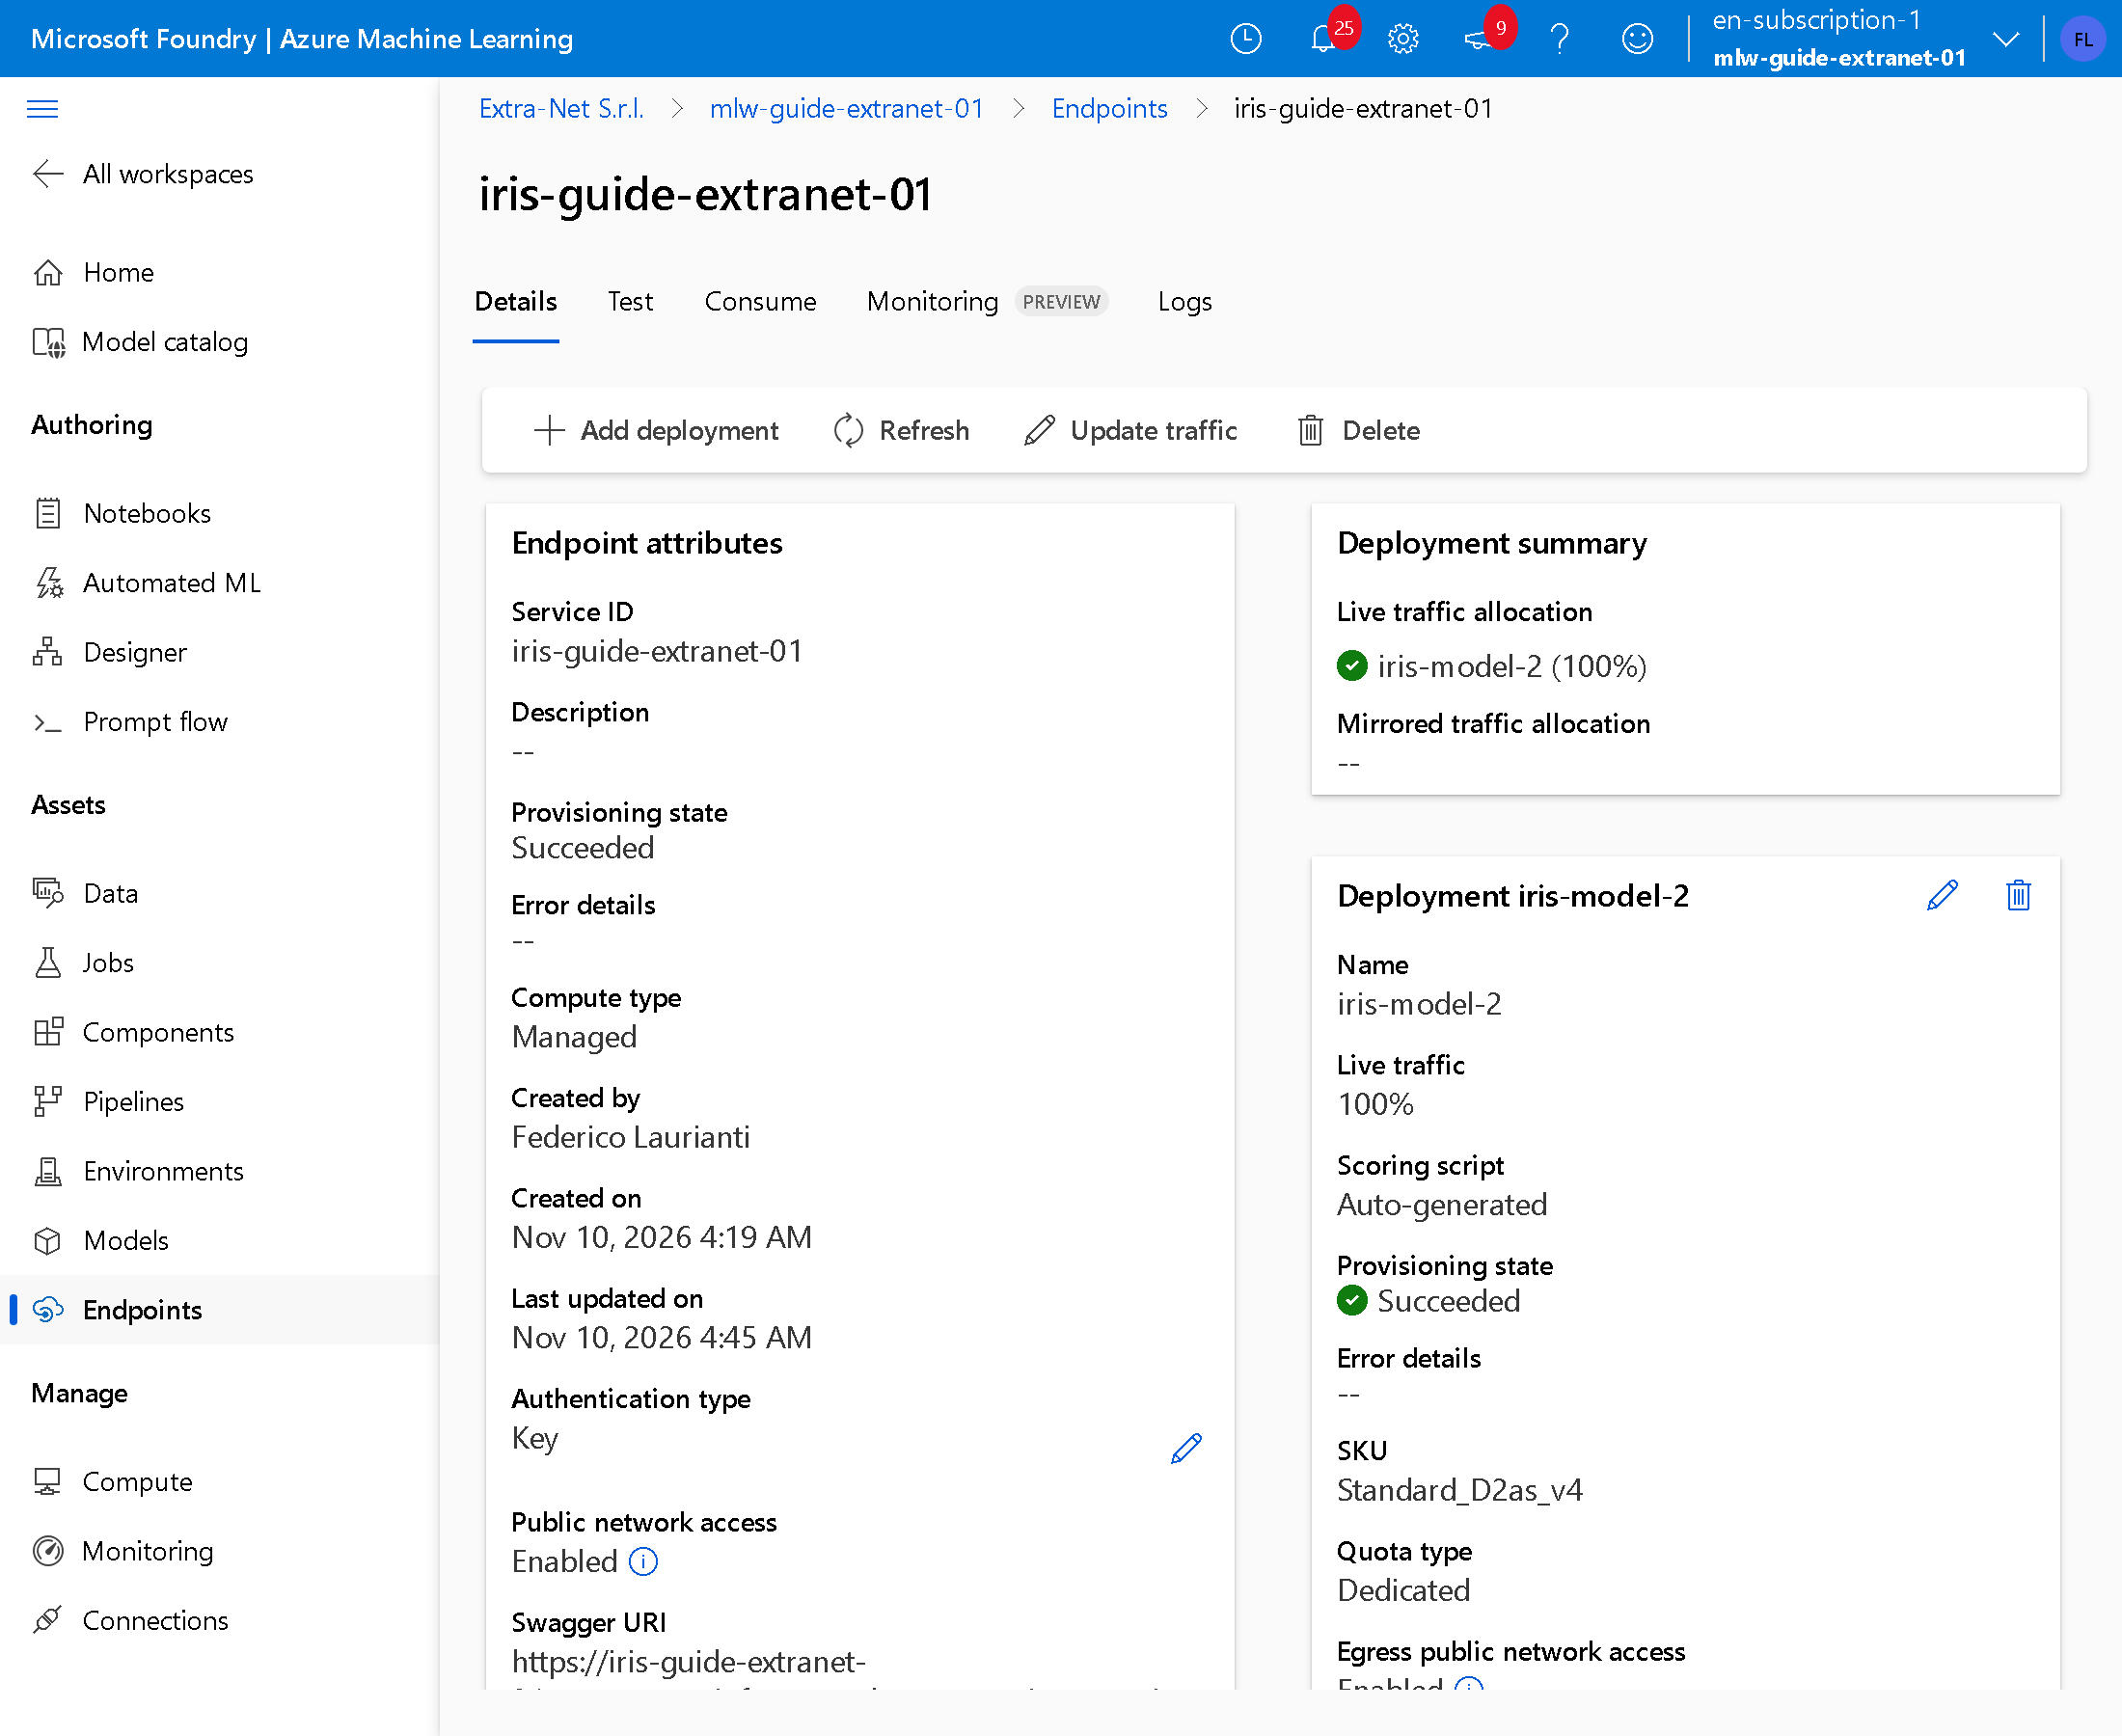
Premi Deploy. Nella prova la pubblicazione ha richiesto 23 minuti, perché Azure costruisce l'immagine con i pacchetti indicati nel modello. Al termine iris-model-2 riceve il 100% del traffico.
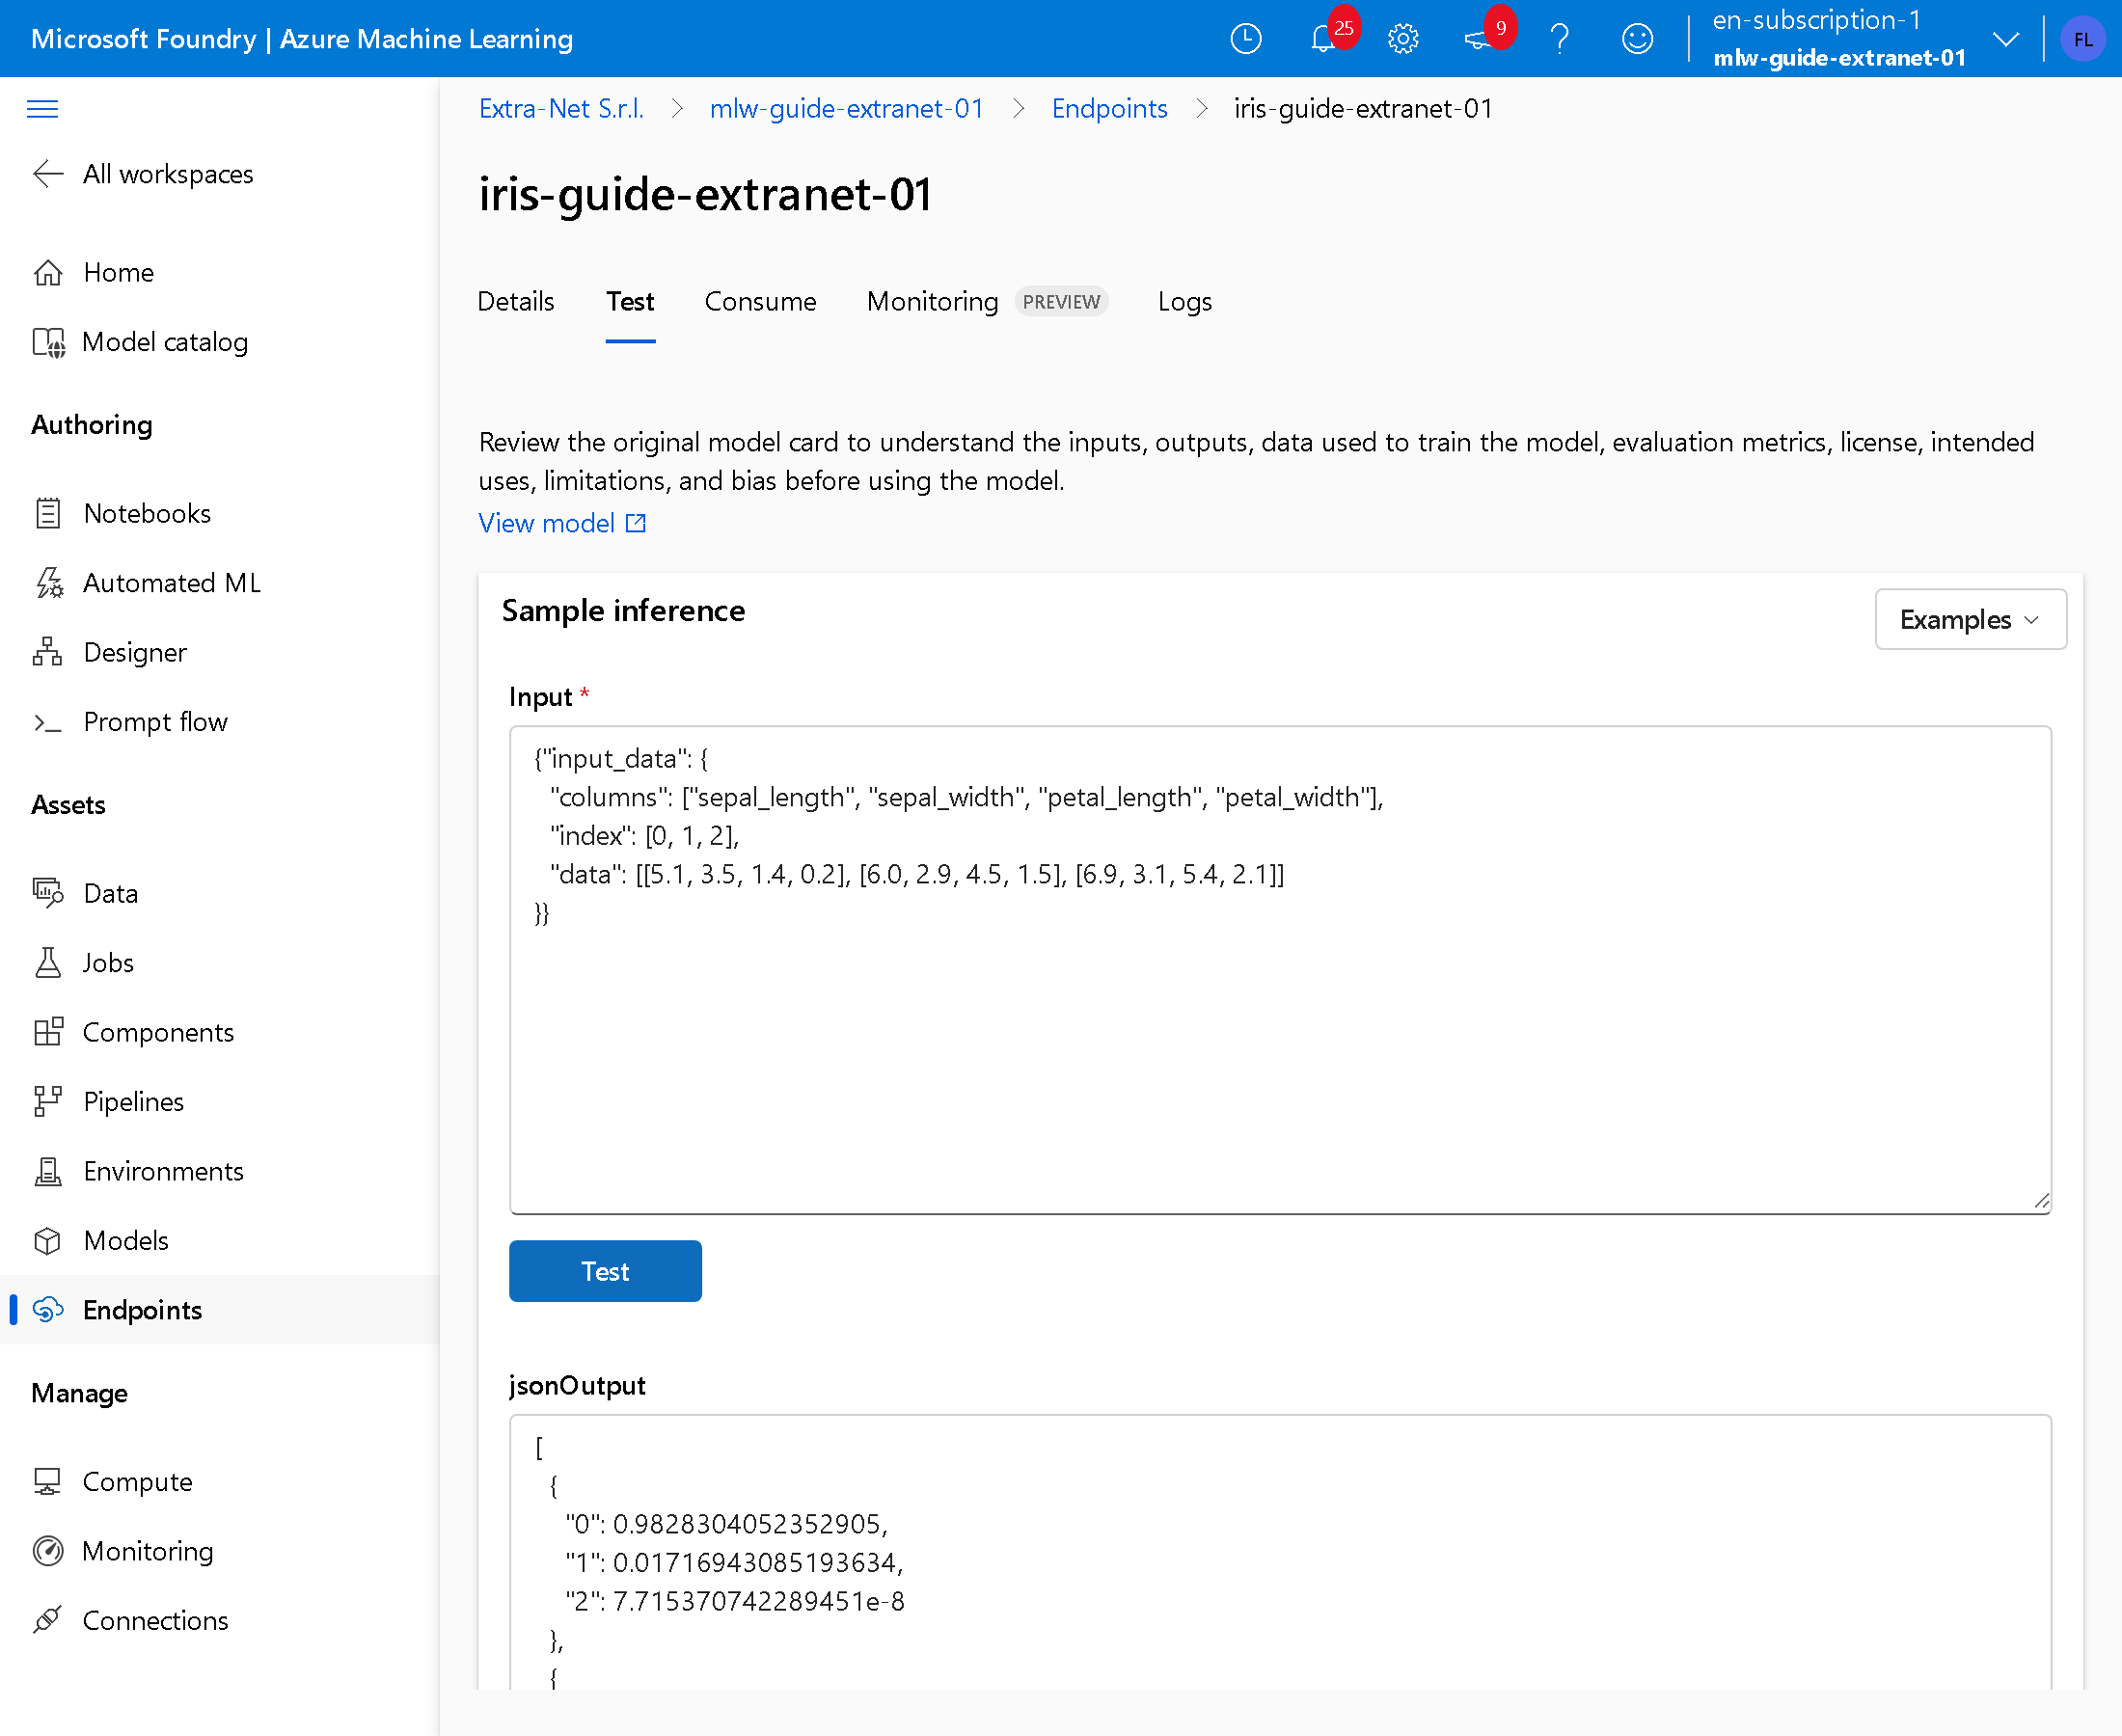
10. Prova dallo studio
Nella scheda Test incolla in Input:
{"input_data": {
  "columns": ["sepal_length", "sepal_width", "petal_length", "petal_width"],
  "index": [0, 1, 2],
  "data": [[5.1, 3.5, 1.4, 0.2], [6.0, 2.9, 4.5, 1.5], [6.9, 3.1, 5.4, 2.1]]
}}
Premi Test. Per ogni fiore la risposta riporta la probabilità delle tre specie: 0 setosa, 1 versicolor, 2 virginica.
11. Copia indirizzo e chiave
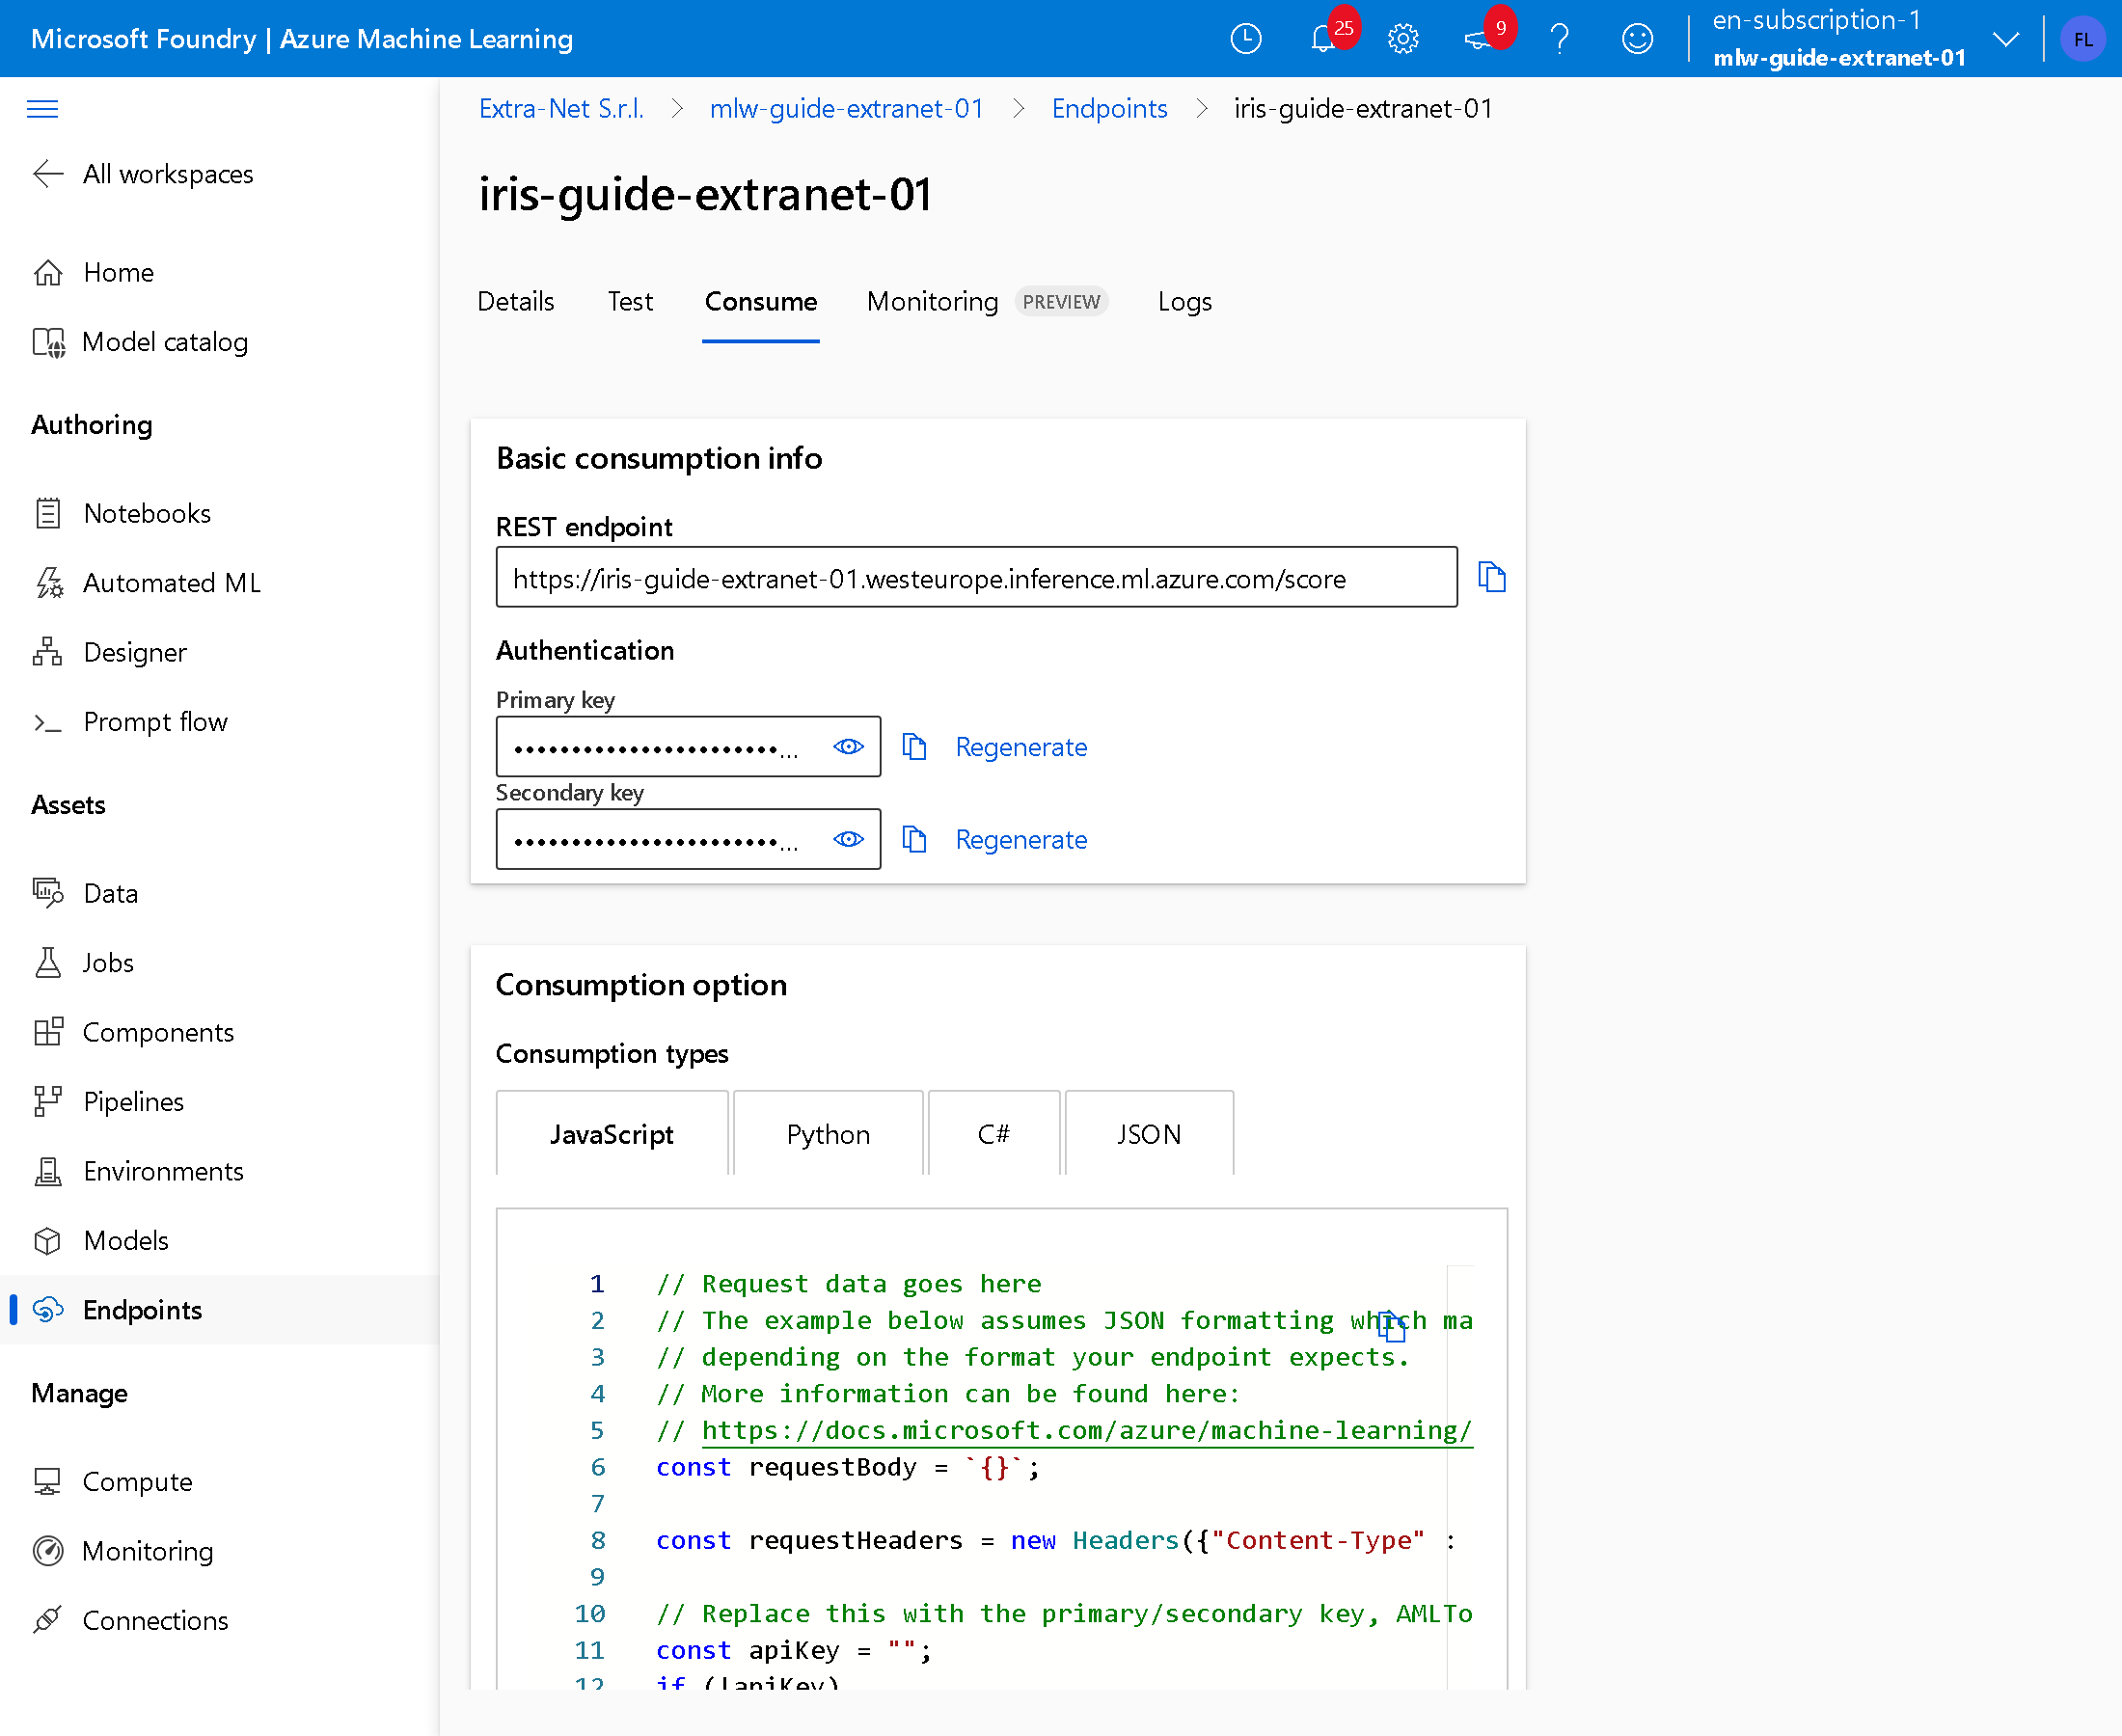
Nella scheda Consume copia REST endpoint e Primary key. La chiave dà accesso al modello: non scriverla nel codice e non pubblicarla.
Il programma .NET
12. Chiama l'endpoint da .NET
dotnet new console -n iris-client
cd iris-client
Sostituisce Program.cs:
using System.Net.Http.Headers;
using System.Net.Http.Json;

string scoringUri = Environment.GetEnvironmentVariable("SCORING_URI")!;
string key = Environment.GetEnvironmentVariable("ENDPOINT_KEY")!;

var request = new
{
    input_data = new
    {
        columns = new[] { "sepal_length", "sepal_width", "petal_length", "petal_width" },
        index = new[] { 0, 1, 2 },
        data = new[]
        {
            new[] { 5.1, 3.5, 1.4, 0.2 },
            new[] { 6.0, 2.9, 4.5, 1.5 },
            new[] { 6.9, 3.1, 5.4, 2.1 },
        },
    },
};

using HttpClient http = new();
http.DefaultRequestHeaders.Authorization = new AuthenticationHeaderValue("Bearer", key);

HttpResponseMessage response = await http.PostAsJsonAsync(scoringUri, request);
Console.WriteLine($"HTTP {(int)response.StatusCode}");
Console.WriteLine(await response.Content.ReadAsStringAsync());
Imposta le due variabili con i valori copiati e avvia:
export SCORING_URI=https://iris-guide-extranet-01.westeurope.inference.ml.azure.com/score
export ENDPOINT_KEY=<chiave>
dotnet run
In PowerShell le prime due righe sono $env:SCORING_URI = "..." e $env:ENDPOINT_KEY = "...". Nella prova:
HTTP 200
[{"0": 0.9828304052352905, "1": 0.01716943085193634, "2": 7.715370742289451e-08}, {"0": 0.006401201244443655, "1": 0.7643778324127197, "2": 0.22922086715698242}, {"0": 0.00015558379527647048, "1": 0.21182303130626678, "2": 0.7880213856697083}]
Il primo fiore è una setosa al 98%, il secondo una versicolor al 76%, il terzo una virginica al 79%. Con una chiave sbagliata l'endpoint risponde HTTP 401.
Eliminare le risorse
13. Elimina il gruppo
Apri il gruppo rg-guide-ml-01. Oltre alle risorse create al passo 1 contiene l'endpoint, la sua pubblicazione e un registro di contenitori che Azure ha creato da solo per l'immagine dell'endpoint.
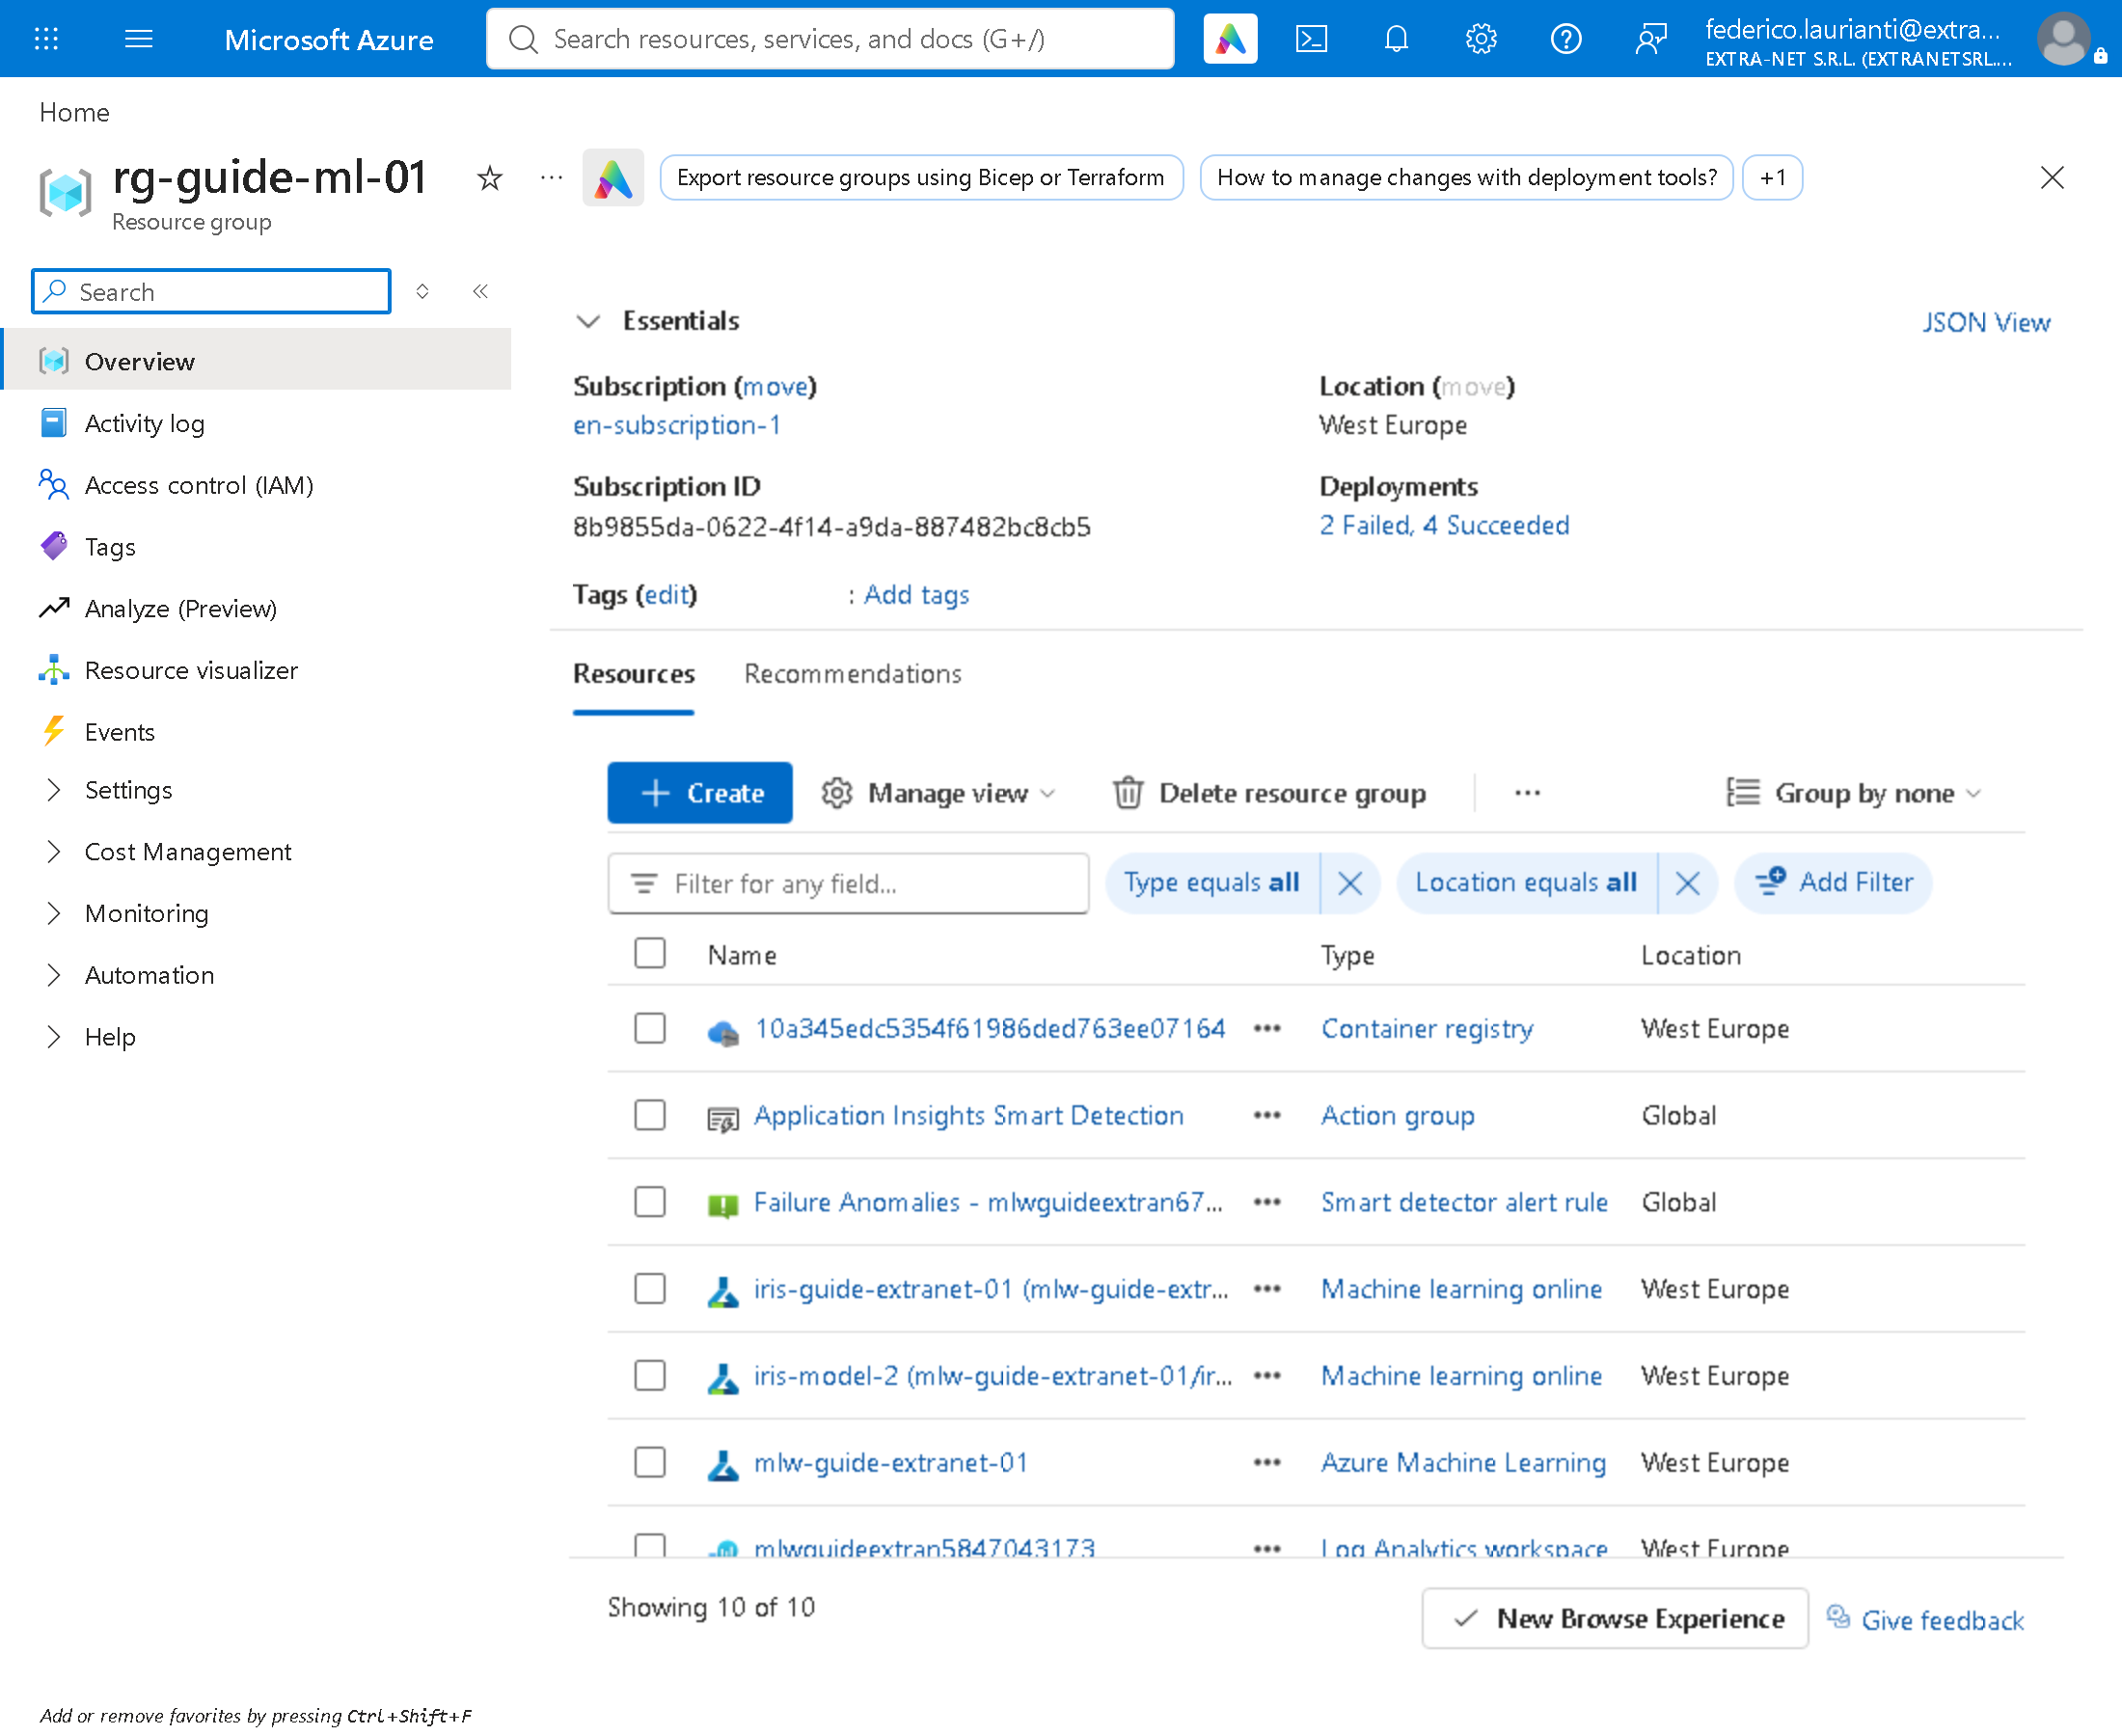
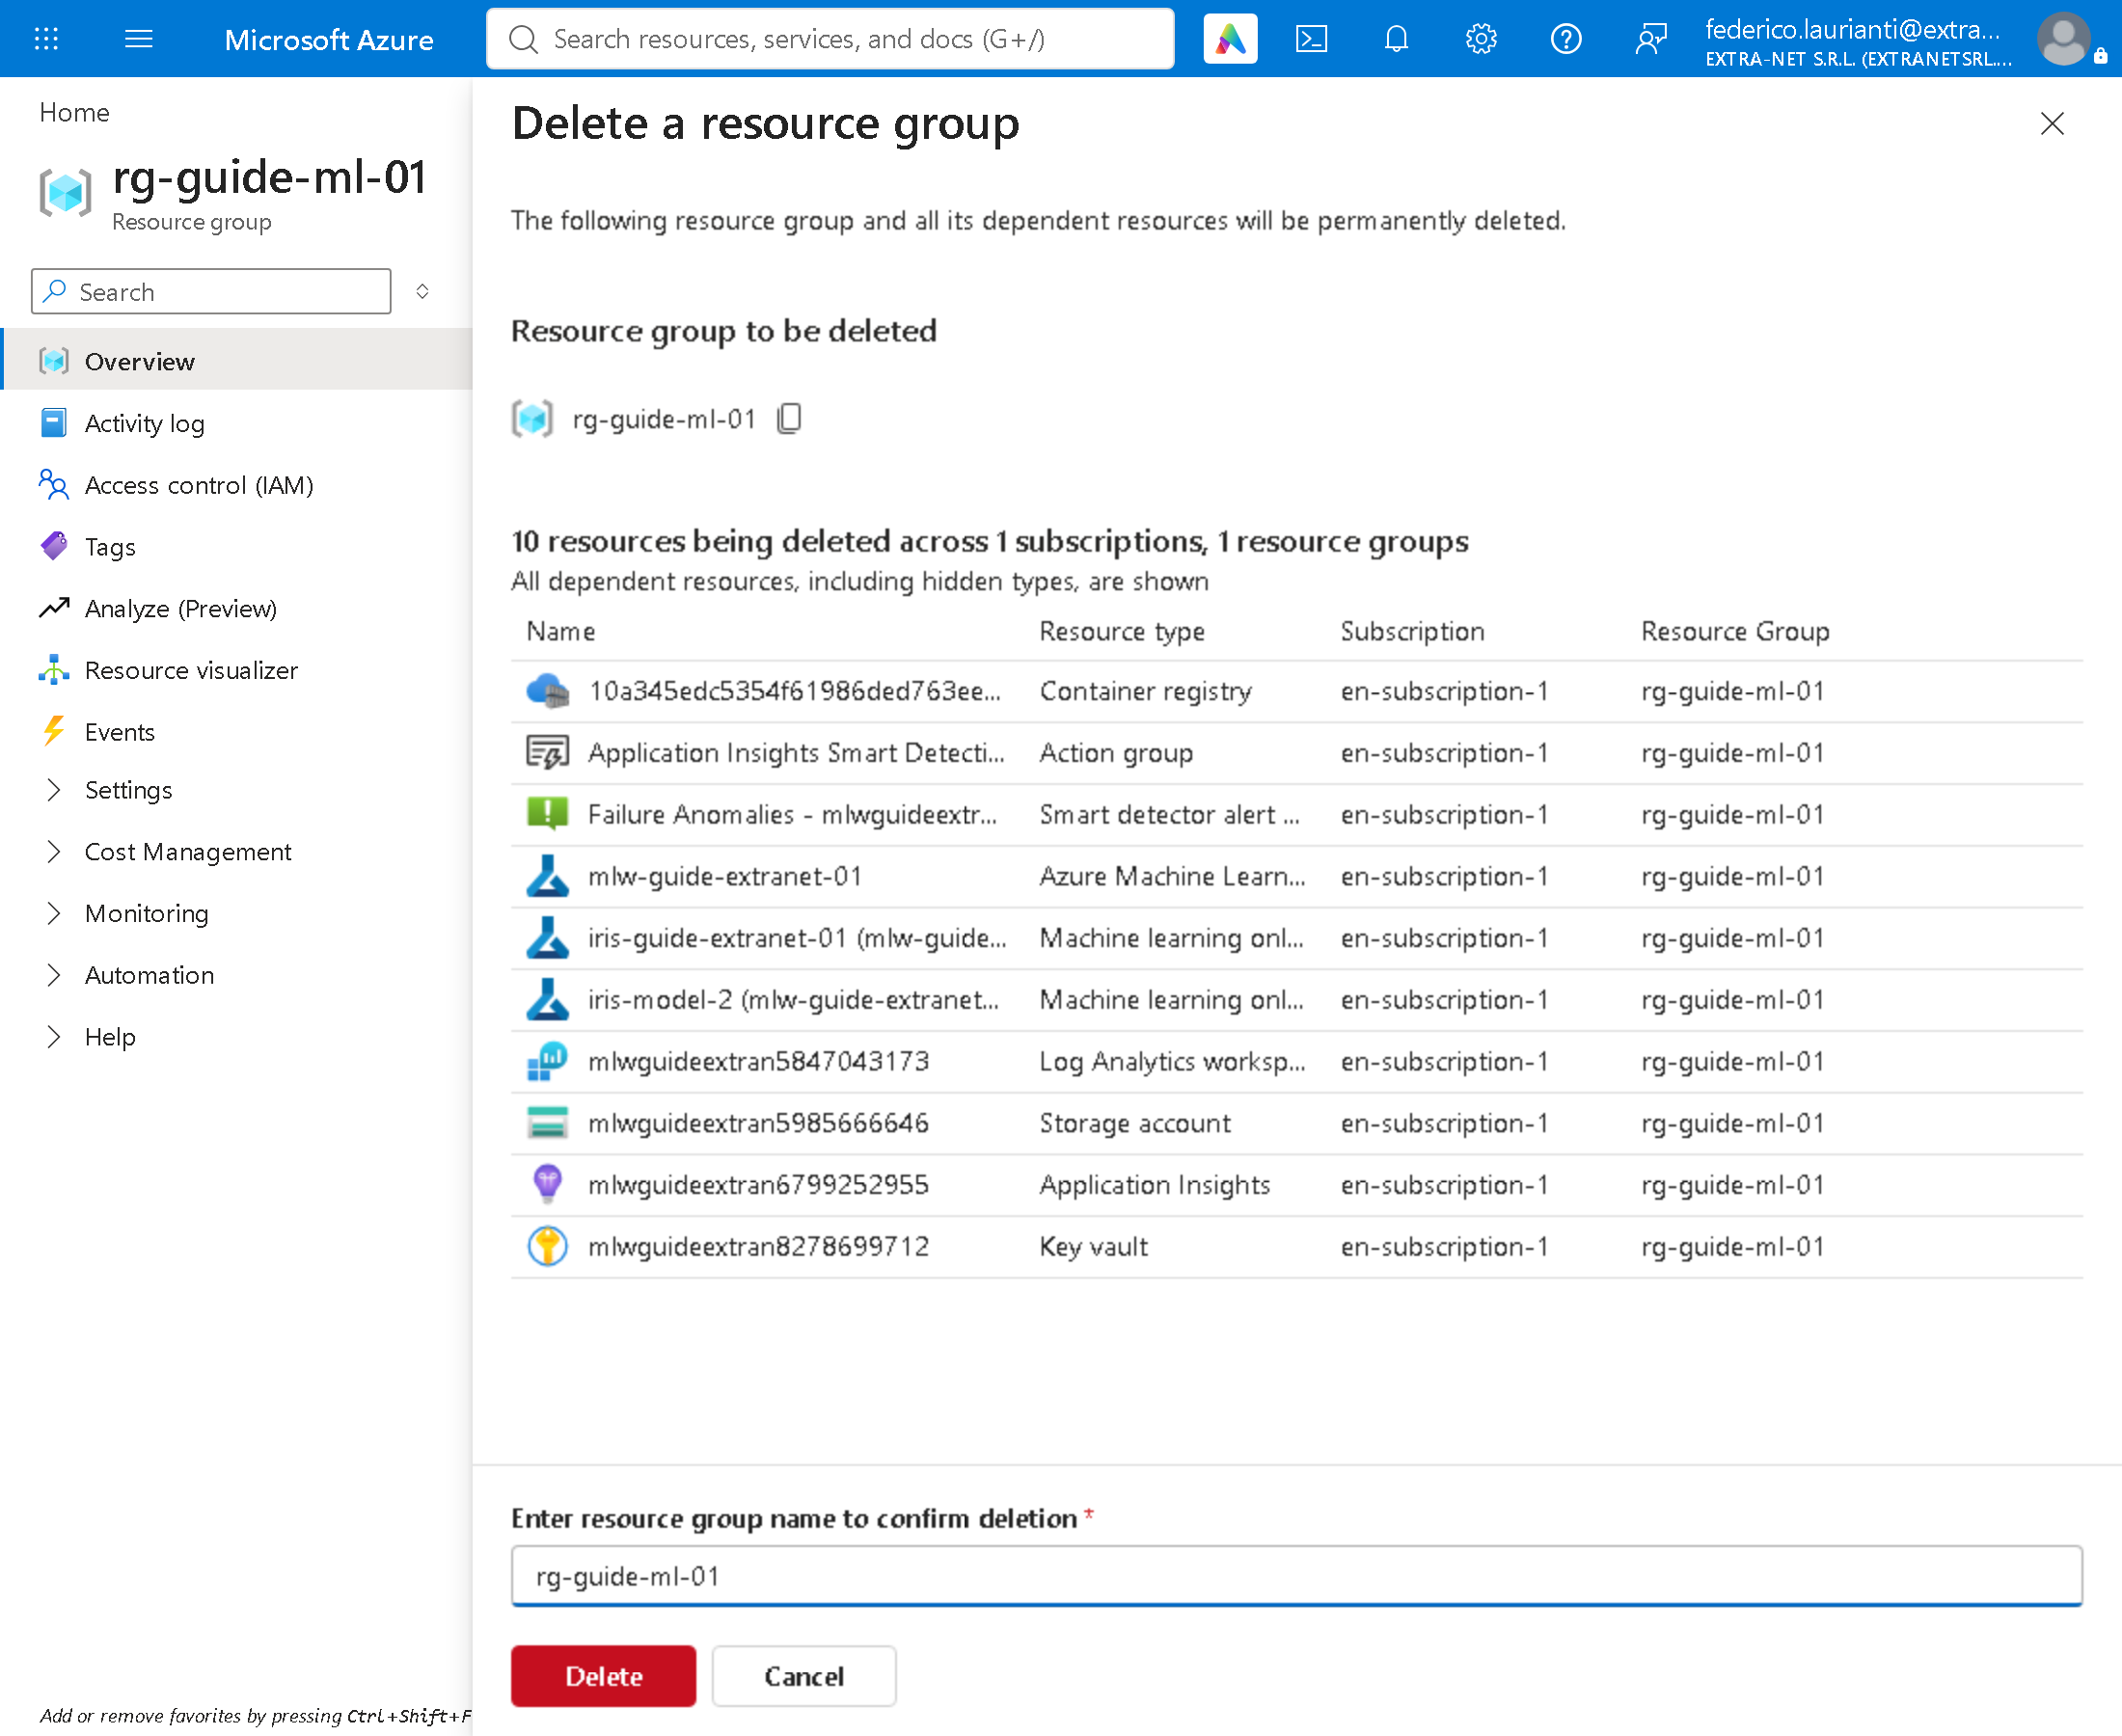
Premi Delete resource group, scrivi il nome del gruppo per confermare, premi Delete e, nella finestra che segue, di nuovo Delete.
14. Elimina in modo definitivo l'area di lavoro
Eliminato il gruppo, Azure tiene l'area di lavoro tra quelle eliminate per 14 giorni. Finché resta lì, la creazione di una nuova area di lavoro con lo stesso nome fallisce con Soft-deleted workspace exists. Please purge or recover it.
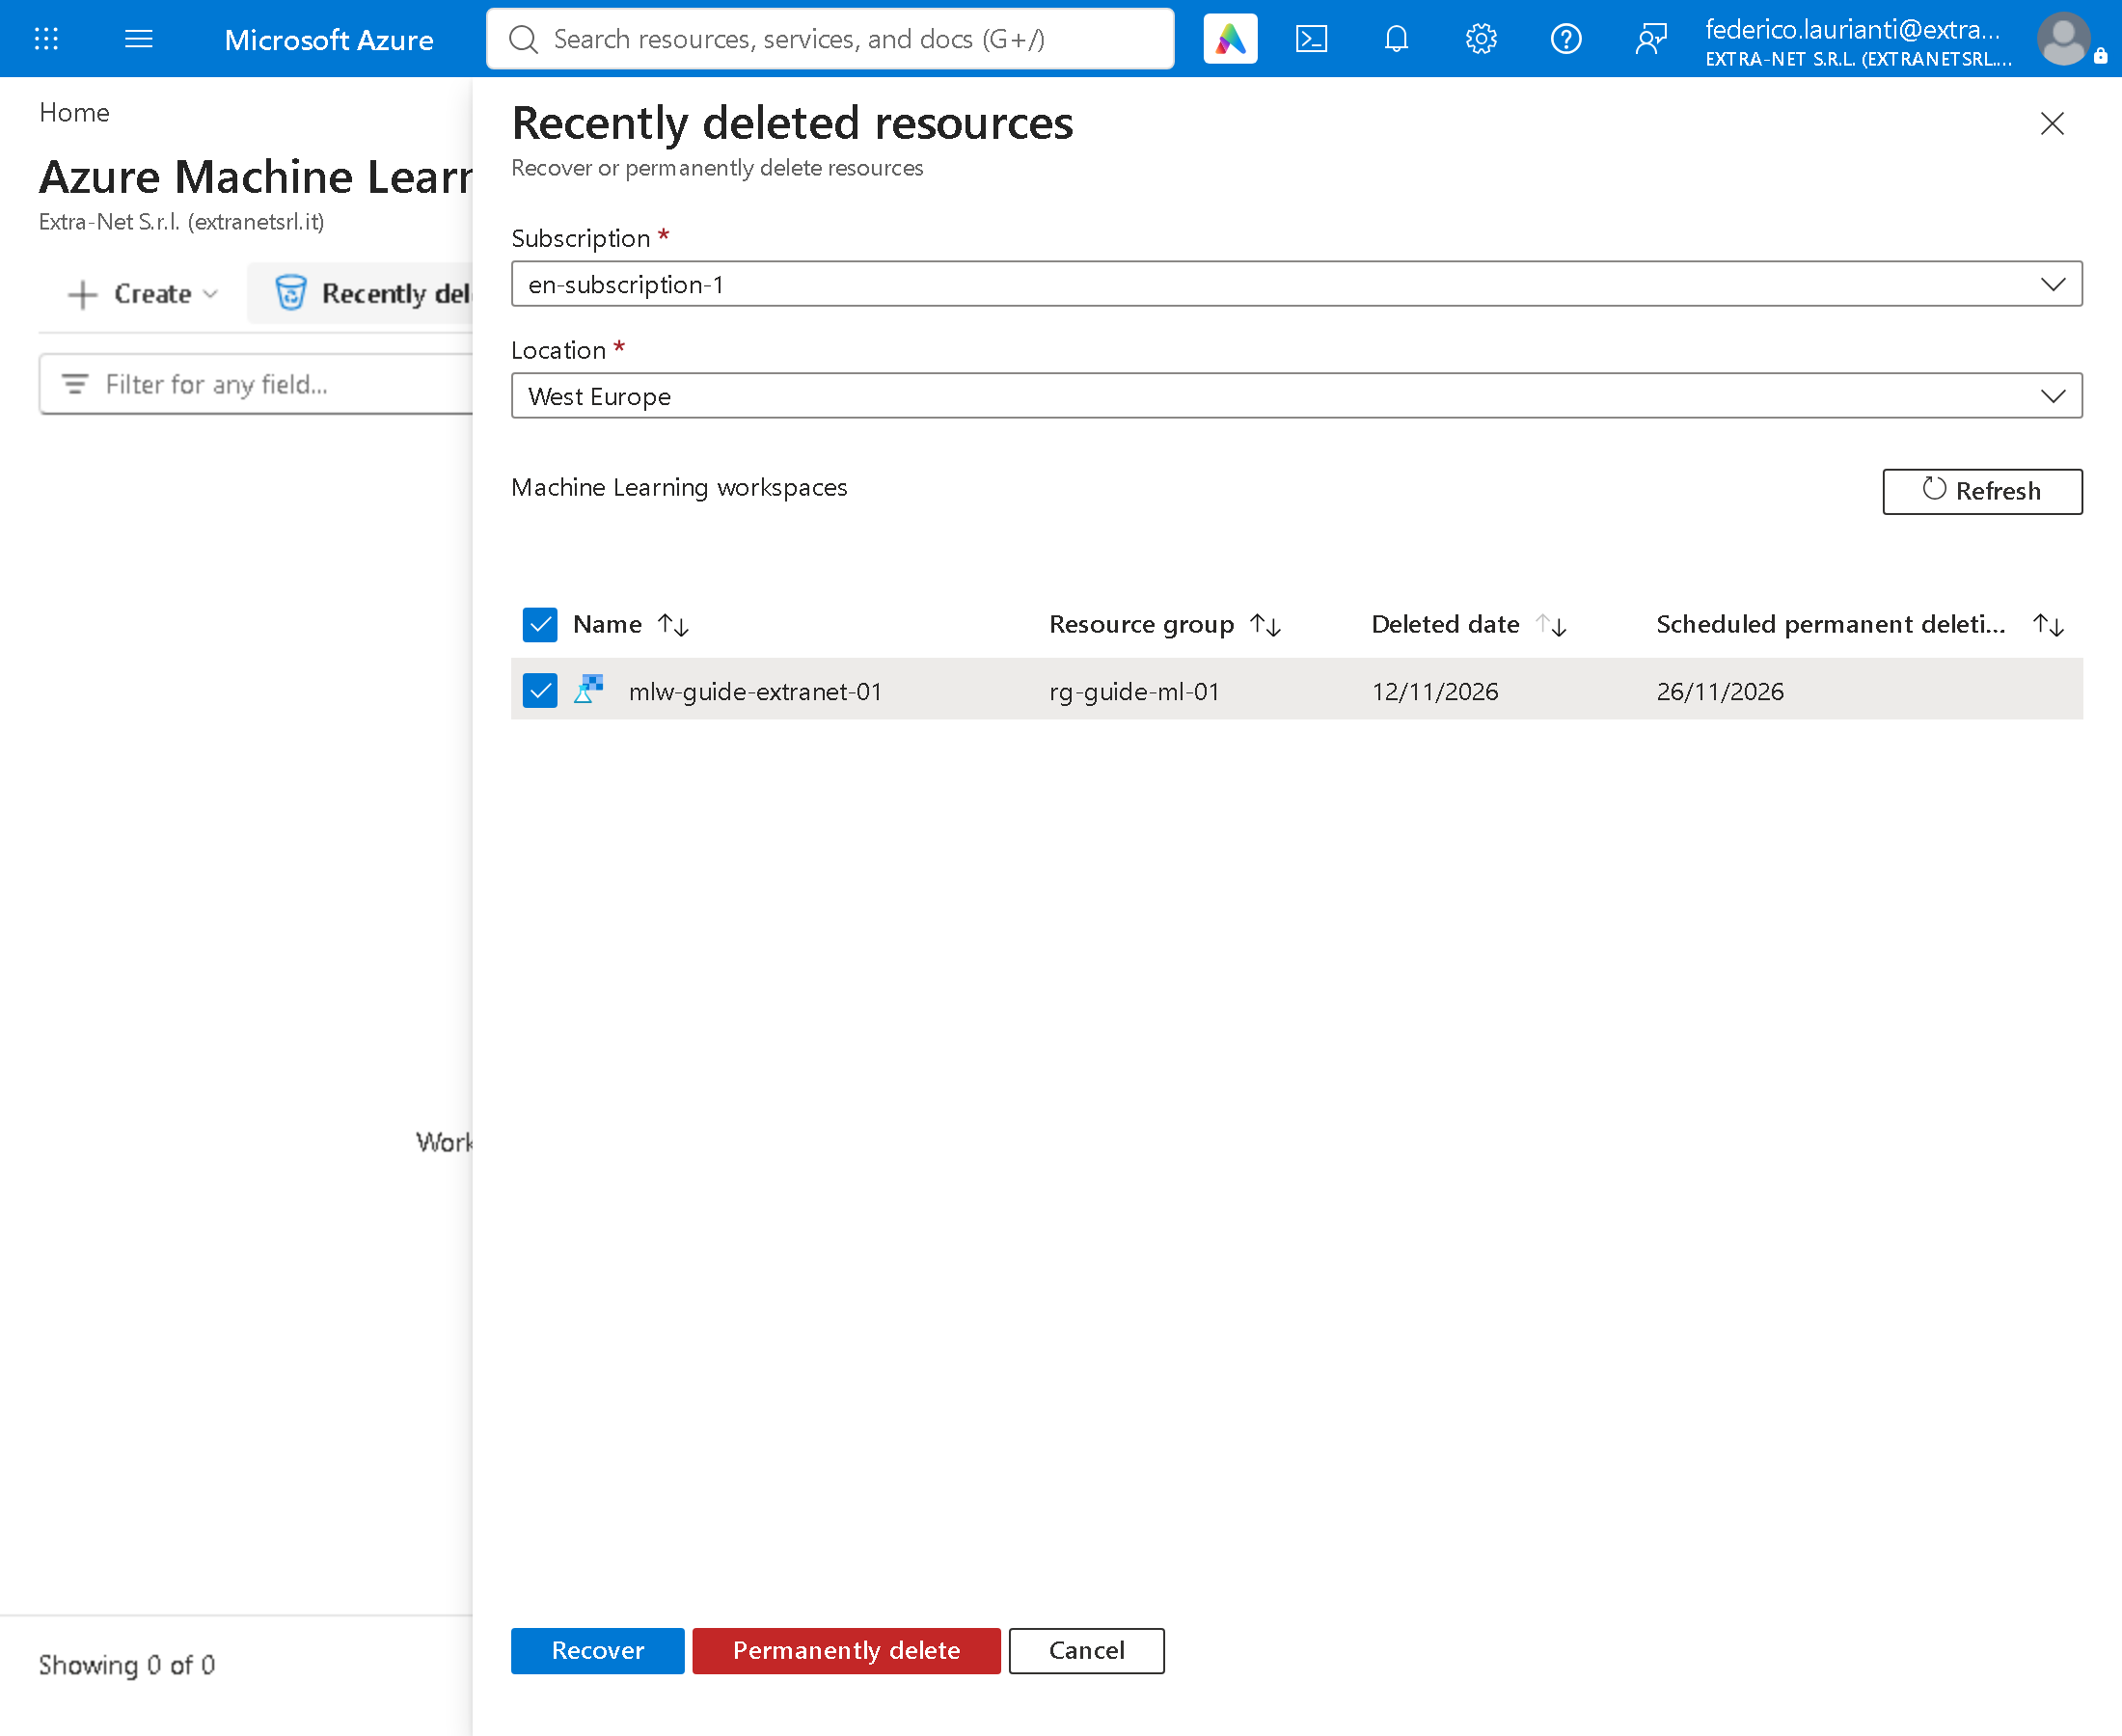
Sul portale cerca Azure Machine Learning, premi Recently deleted, scegli la sottoscrizione e, in Location, West Europe. Spunta mlw-guide-extranet-01 e premi Permanently delete.
Nomi dei comandi, schermate e risposte rilevati il 10 novembre 2026, regione West Europe, con l'ambiente acpt-pytorch-2.8-cuda12.6 versione 21 (PyTorch 2.13.0, MLflow 3.15.0) e .NET 10.0.401; il passo 14 il 12 novembre 2026.